
RLHF 人类反馈强化学习
从"能回答"到"会回答"的价值对齐
🎯 核心概念
来源:RLHF之PPO、DPO详解 | DPO原理深度解析 | RLHF技术问答
什么是RLHF?
定义
RLHF(Reinforcement Learning from Human Feedback) 是一种通过人类偏好数据训练奖励模型,再用强化学习优化语言模型的技术,使模型输出更符合所采集的偏好规范;标注群体与任务覆盖会限制这种对齐。
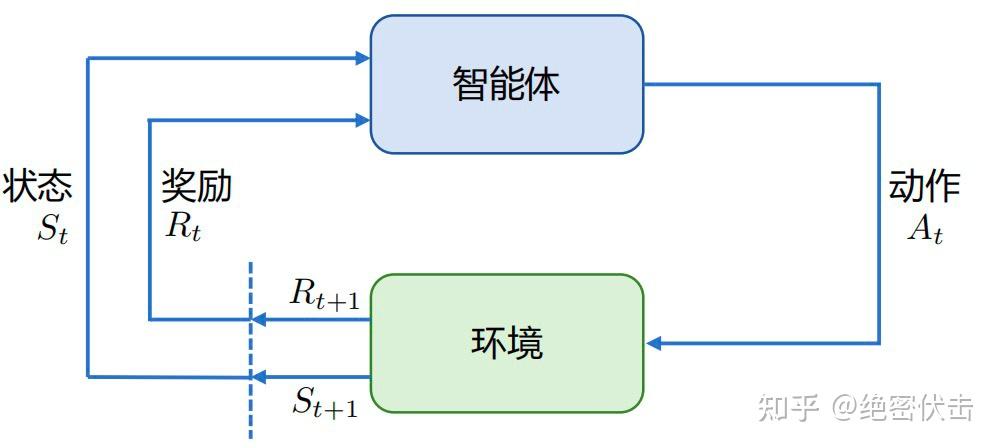 强化学习基本框架:智能体与环境交互
为什么需要RLHF?
InstructGPT 论文展示了“示范 → 偏好排序 → 策略优化”的路线。SFT 提供可执行的行为基线,偏好数据表达多个合理回答之间的取舍。RLHF 并不自动消除幻觉,也不代表学到了所有人的共同价值。
适用条件是:已有较稳定的任务策略、能一致标注的评价规范、能检查奖励模型失准的留出样本,以及承担在线采样成本的预算。只有固定偏好对时,可先比较 DPO;可直接判定结果正确与否的任务,也可能用可验证奖励,但这与“人类反馈”来源应区分。
🔄 RLHF三阶段流程
┌─────────────────────────────────────────────────────────────────────┐
│                         RLHF 三阶段流程                              │
├─────────────────┬─────────────────┬─────────────────────────────────┤
│    阶段一        │    阶段二        │    阶段三                        │
│  监督微调(SFT)   │  奖励模型(RM)    │  强化学习(PPO)                   │
├─────────────────┼─────────────────┼─────────────────────────────────┤
│                 │                 │                                 │
│  指令数据集      │   偏好数据集     │   SFT模型 + RM                  │
│      ↓          │       ↓         │       ↓                         │
│  监督学习       │   对比学习        │   策略优化                       │
│      ↓          │       ↓         │       ↓                         │
│  SFT模型        │   奖励模型        │   对齐模型                       │
│                 │                 │                                 │
└─────────────────┴─────────────────┴─────────────────────────────────┘阶段一:监督微调(SFT)
# 使用高质量指令数据进行监督微调
# 详见 /training/sft 页面阶段二:奖励模型训练
给相同 prompt 的两个回答打偏好标签,常用成对 logistic 损失:-log sigmoid(r(chosen)-r(rejected))。训练输入必须包括 prompt 和回答;否则奖励模型无法判断“是否回答了当前问题”。在未见 prompt 上检查成对准确率、长度偏差、标注分歧与领域切片,再进入策略优化。
以下保留 TRL 历史接口示意,preference_dataset、tokenizer 与数据 collator 需自行配置;PPO 的 value-head / step API 随版本变化,不能当成当前开箱即用脚本。参照 TRL 官方仓库选择固定版本或对应实验目录,本文未进行训练实测。
from transformers import AutoModelForSequenceClassification
from trl import RewardTrainer, RewardConfig

# 1. 准备偏好数据
# 格式: {"prompt": "...", "chosen": "好回答", "rejected": "差回答"}

# 2. 加载奖励模型
reward_model = AutoModelForSequenceClassification.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    num_labels=1  # 输出单一分数
)

# 3. 配置训练
reward_config = RewardConfig(
    output_dir="./reward_model",
    per_device_train_batch_size=4,
    num_train_epochs=1,
    learning_rate=1e-5,
)

# 4. 训练奖励模型
trainer = RewardTrainer(
    model=reward_model,
    args=reward_config,
    train_dataset=preference_dataset,
    tokenizer=tokenizer,
)
trainer.train()阶段三:PPO强化学习
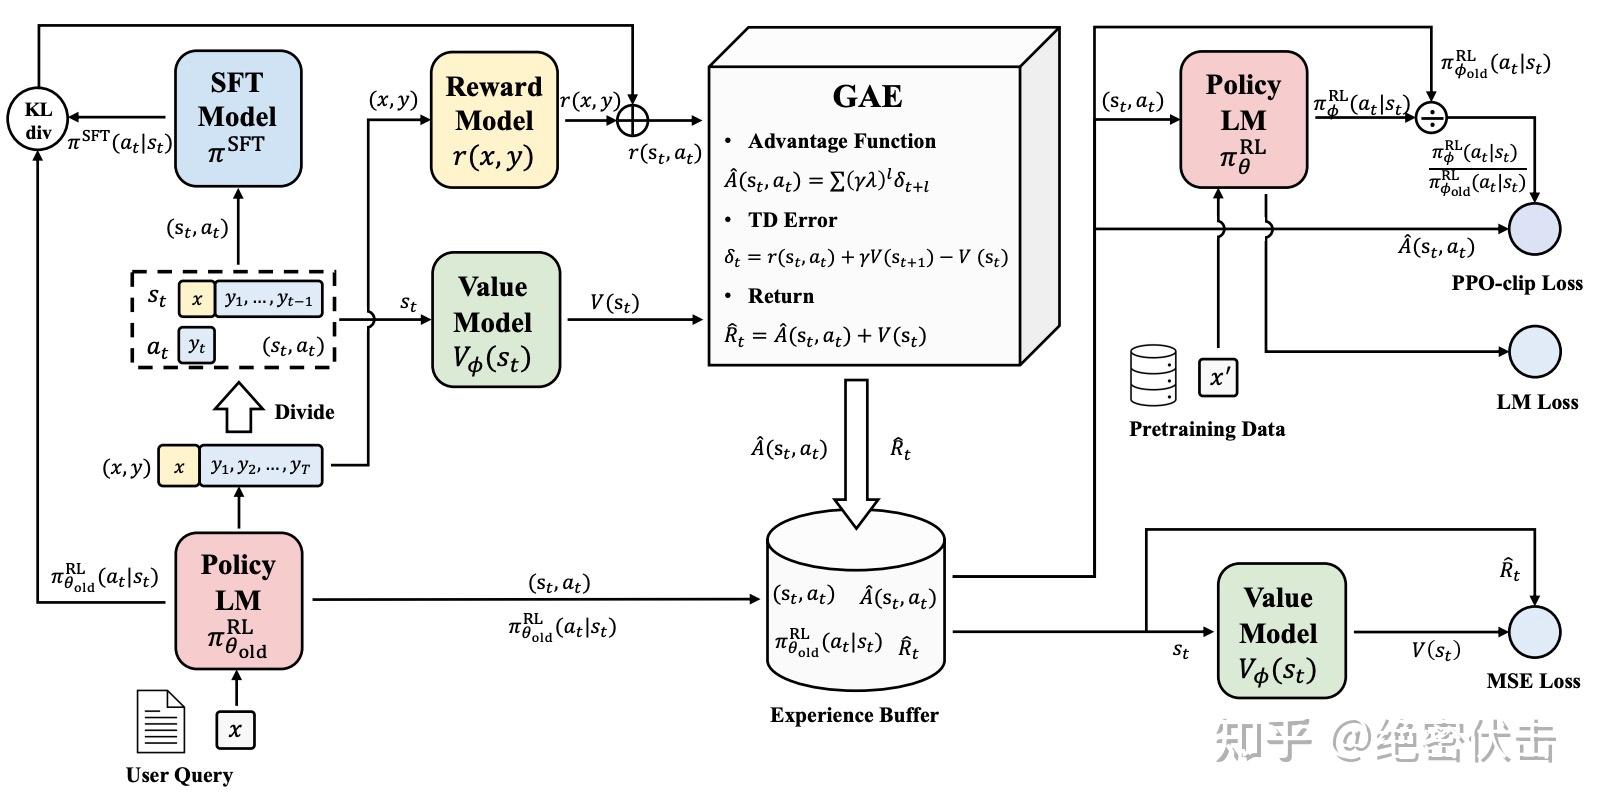 PPO 算法实施流程
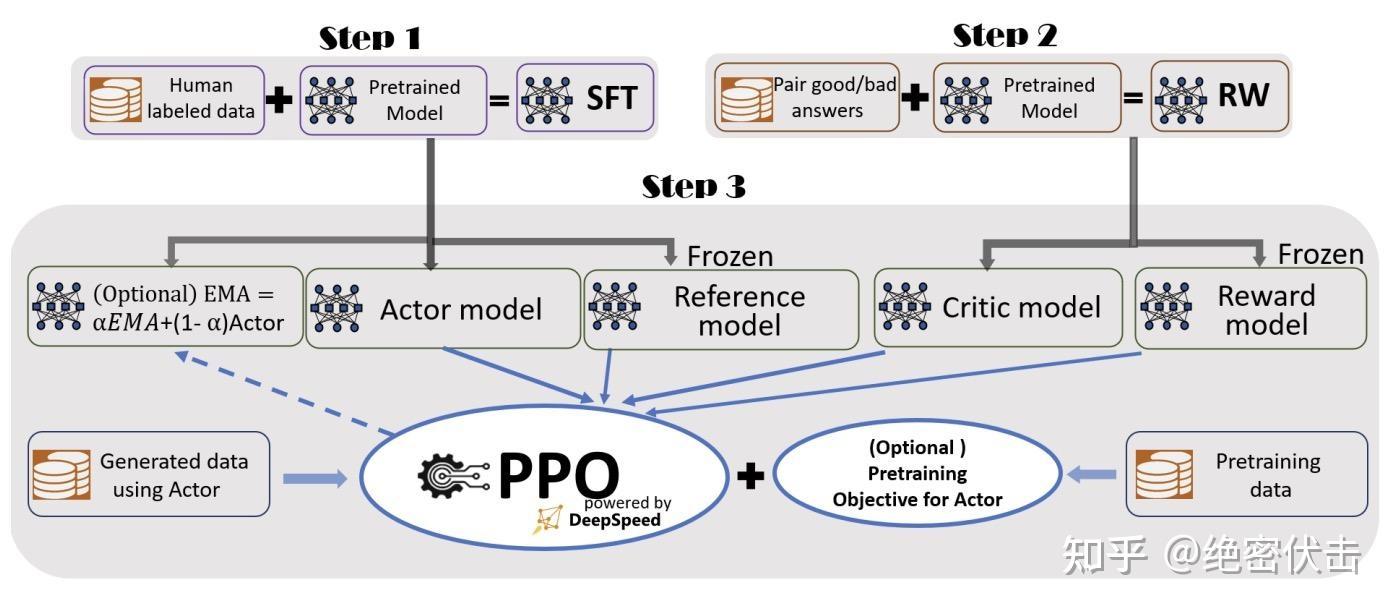 PPO 训练流程详解
from trl import PPOTrainer, PPOConfig, AutoModelForCausalLMWithValueHead

# 1. 加载模型
model = AutoModelForCausalLMWithValueHead.from_pretrained("sft_model")
ref_model = AutoModelForCausalLMWithValueHead.from_pretrained("sft_model")

# 2. PPO配置
ppo_config = PPOConfig(
    learning_rate=1e-5,
    batch_size=16,
    mini_batch_size=4,
    gradient_accumulation_steps=4,
    ppo_epochs=4,
    kl_penalty="kl",           # KL散度惩罚
    init_kl_coef=0.2,          # KL系数
    target_kl=6.0,             # 目标KL值
)

# 3. 创建PPO训练器
ppo_trainer = PPOTrainer(
    model=model,
    ref_model=ref_model,
    config=ppo_config,
    tokenizer=tokenizer,
    dataset=dataset,
)

# 4. 训练循环
for batch in dataloader:
    # 生成响应
    query_tensors = batch["input_ids"]
    response_tensors = ppo_trainer.generate(query_tensors)

    # 计算奖励
    # 伪代码:拼接 prompt+response,经 RM 自己的 tokenizer 编码,
    # 使用 attention mask 取得每条序列的一个标量分数
    rewards = score_prompt_response_pairs(reward_model, query_tensors, response_tensors)

    # PPO更新
stats = ppo_trainer.step(query_tensors, response_tensors, rewards)🏗️ PPO四模型架构
┌─────────────────────────────────────────────────────────────────┐
│                      PPO 四模型架构                              │
├─────────────────┬─────────────────┬─────────────────┬───────────┤
│   策略模型       │   价值模型       │   奖励模型       │  参考模型  │
│   (Policy)      │   (Value)       │   (Reward)      │  (Ref)    │
├─────────────────┼─────────────────┼─────────────────┼───────────┤
│   生成响应      │   预测回报       │   评估质量       │  KL约束   │
│   待训练        │   待训练         │   冻结          │  冻结     │
└─────────────────┴─────────────────┴─────────────────┴───────────┘各模型作用
| 模型 | 作用 | 是否训练 |
|---|---|---|
| 策略模型 | 生成响应,是最终要优化的模型 | ✅ 训练 |
| 价值模型 | 预测未来累积奖励,辅助策略优化 | ✅ 训练 |
| 奖励模型 | 对响应质量打分 | ❌ 冻结 |
| 参考模型 | SFT模型副本,用于计算KL散度 | ❌ 冻结 |
KL散度约束
重要
KL 正则化限制偏离参考策略的程度,可缓解过度优化,但不能保证避免奖励黑客。PPO 的裁剪使用当前策略与采样旧策略的概率比;参考策略用于 KL,二者不能混为一谈。
# 伪代码:在 policy 采样的回答 token 上取 log probability
sample_log_ratio = (policy_logps - reference_logps) * response_mask
sequence_log_ratio = sample_log_ratio.sum(dim=-1)
shaped_reward = rm_score - kl_coef * sequence_log_ratio单个采样的 log ratio 不是完整 KL,可能为负;在对应策略分布上取期望才得到 KL。统计时注明逐 token / 逐序列口径与有效 mask,否则不同回答长度下的 target_kl 不可比较。
⚙️ 关键超参数
| 参数 | 推荐值 | 说明 |
|---|---|---|
| learning_rate | 1e-6 ~ 1e-5 | PPO学习率,比SFT更低 |
| kl_coef | 0.1 ~ 0.2 | KL惩罚系数 |
| target_kl | 按实现与统计口径确定 | 可能用于自适应惩罚或早停,不是通用 6.0 阈值 |
| ppo_epochs | 2-4 | 每批数据的PPO更新次数 |
| clip_range | 0.2 | PPO裁剪范围 |
| vf_coef | 0.1 | 价值函数损失系数 |
🚀 简化方案:DPO
详见 DPO直接偏好优化 页面
RLHF的主要挑战:
- 通常有策略、价值、奖励、参考四个角色;策略与价值会更新,奖励和参考在 PPO 阶段通常冻结,部分角色可共享主干
- 训练不稳定
- 计算成本高
DPO(Direct Preference Optimization) 通过直接优化偏好数据,无需奖励模型:
# DPO只需要:偏好数据 + 策略模型 + 参考模型
# 详见 dpo.md可验证奖励与 GRPO:先设计评分,再选择优化器
核验于 2026-10-08。 可验证奖励 RL(常简称 RLVR)描述的是奖励来源:如数学答案核对、代码隐藏测试或可检查的任务结果;GRPO 是策略优化方法,两者不是同义词。GRPO 也能使用模型打分,人类偏好也可以进入在线 RL。它不会自动把主观评分变成可靠判题。
DeepSeekMath提出 GRPO,用同一问题的一组采样结果构造相对优势,省去单独训练的价值模型。DeepSeek-R1 报告的 R1-Zero 部分使用规则化的正确性与格式奖励;这不能外推为所有开放问答都适合规则奖励,也不能把 R1-Zero 的流程与包含冷启动等阶段的 R1 完整管线混为一谈。
同一 prompt → G 个当前策略回答 → verifier 给出 r₁…rG
典型组内优势:Aᵢ = (rᵢ − mean(r)) / (std(r) + ε)
更新策略时同时明确:重要性比率、裁剪、KL、损失归一化与截断 mask组内奖励全相同时,相对奖励信号为零;持续观察这类组的占比,再排查题目难度、采样多样性和 verifier 是否只输出一个值。采样 G 次、验证程序及可能的推理引擎同步也有成本,省掉 value model 不等于训练成本一定低。
TRL GRPOTrainer 当前文档包含多种损失与奖励归一化选项;复核时文档列出的默认 loss_type="dapo" 与 beta=0.0,已不能简单等同于原论文的全部设置。报告需显式写出 loss_type、scale_rewards、beta、num_generations、截断处理和包版本,不依赖移动中的默认值。组内标准差缩放会改变不同难度题的贡献;关闭缩放后也要关注奖励量级。
一个可审计的最小实验
- 固定 SFT/起始模型与留出题,先验证最终答案提取、单位、异常、超时与代码执行隔离;格式正确不能代替任务正确。
- 用极短 rollout 检查奖励分布、组内方差、有效输出长度、截断率与验证成本,再扩大训练。
- 用未参与奖励开发的题目与 verifier 检查通过率;固定每题采样次数和 token 预算,同时报告 pass@1 与多次采样结果,避免把“多试几次”当成参数能力提升。
- 发现奖励上升但隐藏测试下降时,回看奖励投机、泄漏和分布偏移,先修评分协议再继续训练。
此节核验论文与官方配置语义,未执行 GPU rollout。开放式助手仍需人工/独立评判校准;无法可靠验证的任务不要强行写成二值正确性奖励。
从奖励上涨到真实改善
- 用固定 SFT checkpoint 生成候选,按盲评规范采集偏好;将同一 prompt 家族留在同一切分。
- 奖励模型通过留出排序测试后,先短跑 PPO,同时记录原始奖励、KL 惩罚、熵、clip fraction、value loss 和长度。
- 定期用当前策略生成新的样本进行独立盲评;评估者不能只是训练用的同一个 RM。
- RM 分数涨而人工胜率降时,停止扩大训练,检查冗长、重复、迎合、拒答过度等捷径。KL 突增时核查学习率、rollout 陈旧程度、mask 和参考版本。
验收同时要求业务质量改善、通用/安全回归可接受,以及训练与 rollout 成本可负担。为策略、参考、奖励和数据分别记录版本,回滚时恢复整套制品;只保留最终 policy 权重不足以复现实验。
🔗 相关阅读
相关文章:
外部资源: