
LoRA 高效微调
让消费级显卡也能微调大模型
🎯 核心概念
来源:Fine-Tuning using LoRA and QLoRA - GeeksforGeeks | PEFT技术深度解析
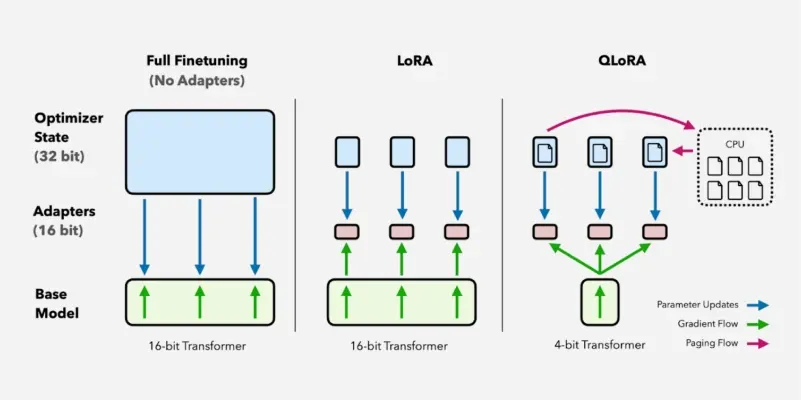 LoRA vs QLoRA 对比
什么是LoRA?
定义
LoRA(Low-Rank Adaptation) 是一种参数高效微调(PEFT)技术,冻结基座权重,在选定线性层上学习低秩增量。参数占比由秩和目标层决定;是否接近全量微调必须在同一数据与预算下验证。LoRA 原始论文报告的是特定模型与任务的实验结果,并非普遍保证。
传统微调 vs LoRA
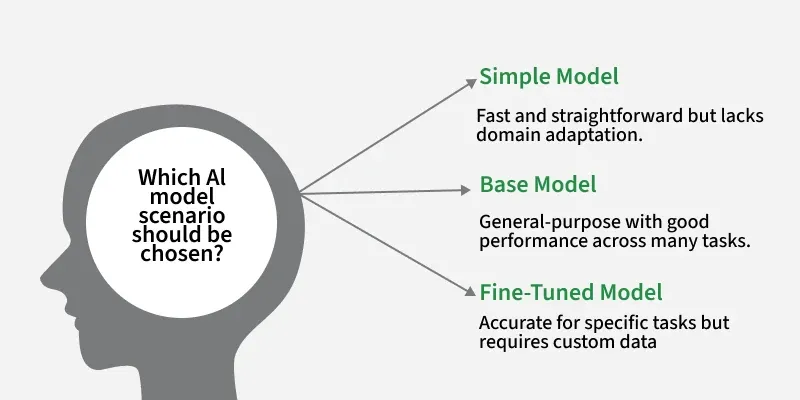 Simple vs Base vs Fine-Tuned Model
传统微调(Full Fine-Tuning):更新预训练模型的全部或大部分参数。对于拥有数十亿参数的模型,这需要大量 GPU 算力、显存和时间,对硬件要求极高。
LoRA 微调:仅更新注入的低秩矩阵,主要节省梯度与优化器状态。前向计算、为适配器传递梯度的反向计算和激活存储仍然存在。
LoRA 原理
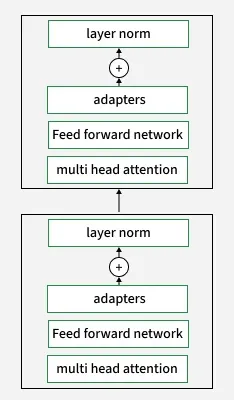 Adapter Layer in LoRA
原始权重 W (d×k)     LoRA分解
     │                  │
     │           ┌──────┴──────┐
     │           │             │
     ▼           ▼             ▼
   冻结        B (d×r)      A (r×k)
     │           │             │
     │           └──────┬──────┘
     │                  │
     ▼                  ▼
  W·x    +           B·A·x
     │                  │
     └────────┬─────────┘
              │
              ▼
W·x + B·A·x (r << d, k)核心思想:
- 对选定线性层增加并行低秩分支,不等同于串联的 bottleneck Adapter
- Adapter 使用低秩矩阵实现
- 微调时只更新 Adapter 参数,核心模型权重(Multi-Head Attention、FFN 等)保持冻结
- 权重更新矩阵 ΔW 分解为两个低秩矩阵的乘积:ΔW = (α/r) B × A(标准 LoRA 缩放;上图省略缩放)
LoRA 核心特性
对一个 d × k 的矩阵,完整更新包含 d × k 个参数,LoRA 的 A/B 包含 r × (d + k) 个参数。以 d = k = 4096,r = 16 为例,单层适配器占原矩阵参数的 0.78%;这不是全模型占比。通常随机初始化 A、零初始化 B,使初始增量为零。
| 特性 | 成立条件与边界 |
|---|---|
| 参数节省 | 统计所有目标层的 A/B,以及额外可训练的 embedding、bias、保存模块 |
| 显存节省 | 冻结权重仍需驻留,激活随序列长度、batch 和检查点策略变化 |
| 泛化 | 参数少不代表不会过拟合;重复样本、错误标签仍可被记住 |
| 合并部署 | 在兼容的浮点基座上合并可移除低秩分支;未合并、多 adapter 路由有额外成本 |
| 模块化 | adapter 必须匹配基座 revision、目标模块、tokenizer 与模板 |
📊 PEFT方法对比
| 方法 | 实际改变 | 主要代价 |
|---|---|---|
| 全量微调 | 更新基座权重 | 梯度、优化器状态和独立模型制品较大 |
| LoRA | 线性层低秩增量 | 秩与覆盖层决定容量;仍有激活开销 |
| QLoRA | 量化冻结基座 + LoRA | 量化元数据、反量化计算和硬件支持 |
| Bottleneck Adapter | 串联小模块 | 未融合时增加推理计算路径 |
| Prefix Tuning | 学习前缀表示 | 前缀占用注意力/KV 预算,效果随任务变化 |
LoRA vs QLoRA
相同目标层和秩下,QLoRA 与 LoRA 的可训练参数数量通常相同。QLoRA 的主要节省来自冻结基座的 4-bit 存储,并非更少的 A/B 参数。NF4、双重量化和分页优化器各处理不同的内存问题。QLoRA 论文
可以先估算:峰值显存 ≈ 基座权重 + 量化元数据 + adapter/梯度/优化器状态 + 激活 + 临时工作区。7B 权重按 BF16 粗算约 14 GB,按纯 4-bit 数据粗算约 3.5 GB;两者都只是权重数据量,不是训练最低显存。因此不能由“1 GB 模型”推导出固定的 2 GB 或 0.5 GB 训练显存。
先固定最长序列和 batch 做短跑并记录峰值,再决定 LoRA 或 QLoRA。量化是否降低吞吐、是否损害业务能力,取决于内核、设备、数据分布和模型。
🔧 LoRA实现
使用PEFT库
以下是配置示例,需要已授权访问的基座、PyTorch、Transformers、PEFT;QLoRA 另需兼容设备上的 bitsandbytes。未进行 GPU 训练实测。训练用单卡明确映射,多卡请交由训练框架配置分片,不把推理用的自动切层当作分布式训练方案。PEFT LoRA 文档
import torch
from peft import LoraConfig, get_peft_model, TaskType
from transformers import AutoModelForCausalLM, AutoTokenizer

# 1. 加载基座模型;此例要求设备支持 BF16
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
tokenizer.pad_token = tokenizer.eos_token
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    torch_dtype=torch.bfloat16,
    device_map={"": 0}
)

# 2. 配置LoRA
lora_config = LoraConfig(
    r=16,                          # 低秩维度
    lora_alpha=32,                 # 缩放因子
    target_modules=[               # 目标模块
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj"
    ],
    lora_dropout=0.05,             # Dropout比例
    bias="none",                   # 不训练偏置
    task_type=TaskType.CAUSAL_LM   # 任务类型
)

# 3. 应用LoRA
model = get_peft_model(model, lora_config)

# 4. 查看可训练参数
model.print_trainable_parameters()
# 以实际输出为准:目标层和 r 改变后,不能复用别的配置的参数统计QLoRA(Quantized LoRA)
QLoRA 将基座模型以 4-bit 量化格式加载,大幅减少显存占用,同时以更高精度(如 16-bit)训练 LoRA 适配器。
实现要点:冻结基座以 NF4 存储,在计算时反量化;计算 dtype 与 adapter 参数 dtype 应分别检查,不要假设所有张量都是 4-bit。双重量化压缩量化常数;分页优化器缓解状态管理的内存峰值,但不会消除激活的显存需求。all-linear 是值得比较的覆盖策略,也需要检查实际命中的层。
from transformers import BitsAndBytesConfig
from peft import prepare_model_for_kbit_training

# 1. 4-bit量化配置
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",           # NormalFloat4量化
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True       # 双重量化
)

# 2. 加载量化模型
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    quantization_config=bnb_config,
    device_map={"": 0}
)

# 3. 准备模型进行k-bit训练
model = prepare_model_for_kbit_training(model)

# 4. 应用LoRA(建议应用到所有线性层)
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules="all-linear",  # 对于 QLoRA,建议应用到所有线性层
    lora_dropout=0.05,
    bias="none",
    task_type=TaskType.CAUSAL_LM
)
model = get_peft_model(model, lora_config)⚙️ 关键超参数
r(秩)
先用 r=8 或 16 建立基线,再在固定训练 token 预算下比较更小或更大的秩。r 增大会增加容量和参数量,但效果不单调;若任务分布不匹配,盲目加秩无益。将目标层覆盖、学习率和 r 分开做消融,避免同时变化后无法解释收益。
lora_alpha
# 实际缩放因子 = lora_alpha / r
# 常用配置:lora_alpha = 2 * r

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,  # 缩放因子2
    # ...
)target_modules
| 模型 | 推荐目标模块 |
|---|---|
| LLaMA/Qwen | q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj |
| GPT-2 | c_attn, c_proj, c_fc |
| BLOOM | query_key_value, dense, dense_h_to_4h, dense_4h_to_h |
# 检查基座实际模块名;模型家族名称不保证所有版本使用相同命名
for name, module in model.named_modules():
    if isinstance(module, torch.nn.Linear):
        print(name)

# 或手动指定
target_modules = ["q_proj", "v_proj"]  # 最小配置
target_modules = "all-linear" # 所有线性层📈 训练流程
完整训练脚本
下面续接已经包装为 PeftModel 的 model,不再重复传 peft_config。dataset 须是含 text 字段的 Dataset,或使用 SFT 页 的 prompt/completion 数据。参数仅用于小规模起跑。
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./lora_output",
    max_length=2048,
    num_train_epochs=1,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=8,
    learning_rate=1e-4,
    logging_steps=10,
    gradient_checkpointing=True,
    bf16=True,  # 先确认设备支持;不支持时调整精度
)
trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=dataset,
    processing_class=tokenizer,
)
trainer.train()
model.save_pretrained("./lora_weights")
tokenizer.save_pretrained("./lora_weights")训练前先检查一个 batch 的解码文本、有效 labels、截断比例与梯度;训练后在留出集生成回答。SFTConfig/processing_class 对应复核时的 TRL 文档,项目需锁定实际运行版本。
合并权重
合并时重载与训练一致的基座 revision。QLoRA 训练后可在浮点基座合并,再单独量化部署;合并前后及重新量化后各做一次固定输入回归,允许数值误差但检查任务结果、模板和停止行为。
from peft import PeftModel

# 加载基座模型
base_model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf")

# 加载LoRA权重
model = PeftModel.from_pretrained(base_model, "./lora_weights")

# 合并权重
merged_model = model.merge_and_unload()

# 保存完整模型
merged_model.save_pretrained("./merged_model")当前 PEFT:训练收益还要通过推理验收
2026-10-08 对照 PEFT v0.21.0 LoRA 文档,以下是影响工程决策的区别,非方法排名。
| 选择 | 改变了什么 | 必须核对 |
|---|---|---|
target_modules="all-linear" | 在支持的模型上覆盖 linear/Conv1D;PreTrainedModel 的输出层排除 | 实际命中的模块、可训练参数及显存;不是只改 attention |
use_rslora=True | 缩放从 alpha/r 改为 alpha/√r | 不能沿用原 LoRA 的 rank/alpha 结论而不重测 |
| 普通 LoRA 合并 | 将静态权重增量写入兼容基座 | 同一底座 revision;合并和重新量化后分别回归 |
| aLoRA | 从指定 invocation token 序列起启用适配器 | 激活前可复用兼容基座 KV;激活后的 KV 不能混用,且不能合并成普通静态权重 |
只有任务确实是“长共享前缀之后调用专用适配器”时,才值得评估 aLoRA;它不是普通 LoRA 权重的即插即用推理开关,需要对应训练与模板。文档语义已核验,本文未运行这些变体,也不承诺速度收益。
部署验收把适配器 ID、底座 revision、模板、量化与服务引擎写入制品清单。分别测加载、切换、合并与缓存失效;可训练参数少不能推导首 token 延迟低。缓存共享必须遵循对应方法与推理引擎的兼容规则。
🎯 最佳实践
显存优化
# 1. 使用梯度检查点
model.gradient_checkpointing_enable()

# 2. 使用8-bit优化器
training_args = TrainingArguments(
    optim="paged_adamw_8bit",
    # ...
)

# 3. 使用Flash Attention(如果支持)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    attn_implementation="flash_attention_2"
)多LoRA适配器
from peft import PeftModel

# 加载基座模型
base_model = AutoModelForCausalLM.from_pretrained("base_model")

# 加载多个LoRA适配器
model = PeftModel.from_pretrained(base_model, "lora_adapter_1")
model.load_adapter("lora_adapter_2", adapter_name="adapter2")

# 切换适配器
model.set_adapter("adapter2")

# 或合并多个适配器
model.add_weighted_adapter(
    adapters=["default", "adapter2"],
    weights=[0.7, 0.3],
    adapter_name="merged"
)性能基准与发现
LoRA vs 全量微调
用同一训练/留出切分、相同模板和生成参数比较:未微调基座、LoRA、QLoRA,以及预算允许时的全量微调。记录可训练参数、峰值显存、有效 token/s、领域成功率和通用回归;不要把某篇论文的 GLUE 分数或显存降幅移植到另一个模型。
Adapter 效率权衡
单个合并适配器、动态切换适配器、多租户混批是三种不同部署条件。选择后两者时,需要把 adapter 加载、缓存命中、切换和批处理碎片计入 P95 延迟。
失败定位与验收
| 现象 | 首先排查 | 验收证据 |
|---|---|---|
| loss 不降、参数不变 | 目标模块是否命中、可训练参数与梯度是否非零 | 短跑中 adapter 有有限梯度且权重变化 |
| 加长上下文后 OOM | 激活与 attention 工作区,而非仅基座大小 | 最大业务长度下峰值显存与余量 |
| 训练好、上线差 | 基座版本、模板、adapter 加载、量化顺序 | 同一输入在训练和服务路径输出对照 |
| 领域涨、通用降 | 数据偏窄、过拟合、学习率与混合配比 | 领域与通用回归同时达到预设门槛 |
发布制品包括基座 revision、adapter 配置、tokenizer、模板、依赖锁定和评估报告;adapter 文件能加载不等于实验成功。
🔗 相关阅读
相关文章:
外部资源: