
部署与推理优化
让大模型跑得更快、更省
🎯 核心挑战
部署难点
| 挑战 | 问题 | 解决方案 |
|---|---|---|
| 显存占用 | 7B BF16 权重约 14 GB,另需 KV/激活/工作区 | 量化、上下文预算与并发控制 |
| 推理速度 | 自回归生成慢 | KV Cache、批处理 |
| 成本 | GPU昂贵 | CPU推理、边缘部署 |
| 延迟 | 排队、prefill 或 decode 各自占时 | 分阶段测量;推测解码主要针对生成阶段 |
🗜️ 模型量化
量化类型
下表比例仅按理想权重位宽相对 FP32 计算,不是进程显存降幅;还要计入 scales、零点、未量化层、KV 与内核工作区。质量损失必须按任务测试。
| 类型 | 精度 | 显存节省 | 精度损失 |
|---|---|---|---|
| FP32 | 32位 | 基准 | 无 |
| FP16/BF16 | 16位 | 50% | 极小 |
| INT8 | 8位 | 75% | 小 |
| INT4 | 4位 | 87.5% | 中等 |
| INT2 | 2位 | 93.75% | 较大 |
量化方法
| 方法 | 原理 | 适用场景 |
|---|---|---|
| PTQ(训练后量化) | 直接量化已训练模型 | 快速部署 |
| QAT(量化感知训练) | 训练时模拟量化 | 追求精度 |
| GPTQ | 基于Hessian的逐层量化 | 4-bit高精度 |
| AWQ | 激活感知量化 | 保护重要权重 |
| GGUF | 存储格式,可容纳多种量化类型 | llama.cpp 等运行时,支持情况依设备 |
BitsAndBytes量化
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 8-bit量化
model_8bit = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    load_in_8bit=True,
    device_map="auto"
)

# 4-bit量化(NF4)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True
)

model_4bit = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    quantization_config=bnb_config,
    device_map="auto"
)GPTQ量化
from transformers import AutoModelForCausalLM, GPTQConfig

gptq_config = GPTQConfig(
    bits=4,
    dataset="c4",
    tokenizer=tokenizer
)

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    quantization_config=gptq_config,
    device_map="auto"
)🚀 推理优化
来源:FlashAttention 详解 | FlashAttention V2 | vLLM 官方博客 | PagedAttention 论文
FlashAttention
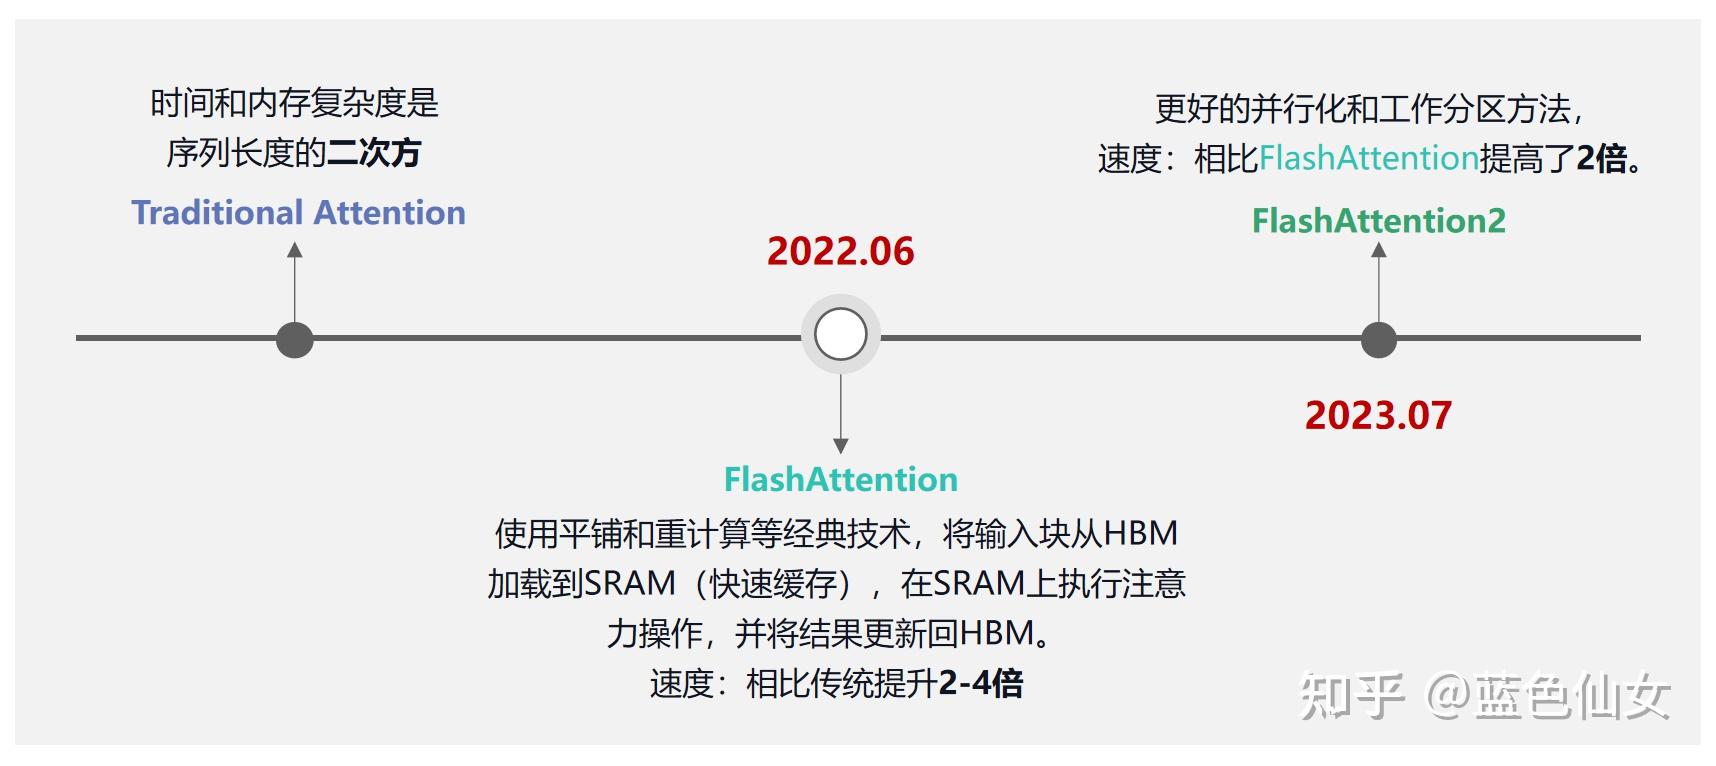 FlashAttention 分块计算原理
FlashAttention是 IO 感知的精确注意力算法,通过分块和在线 softmax 减少 HBM 访问。公开实现广泛使用该思想,但不据此推断未公开模型的内部实现。
核心技术:
| 技术 | 说明 |
|---|---|
| Tiling(分块) | 将 Q、K、V 分成小块放入 SRAM |
| Kernel Fusion | 多个计算步骤合并为单一 CUDA kernel |
| Recomputation | 反向传播时重算中间结果,用计算换存储 |
| Online Softmax | 分块计算 Softmax,无需完整注意力矩阵 |
效果:
- 避免把完整 N×N 注意力矩阵写入 HBM,辅助存储可降为线性规模;精确稠密 attention 的算术量仍是二次的。
- IO 复杂度还取决于 head 维度与 SRAM 容量;加速比例需结合 GPU、序列长度、batch 和内核版本测量。
vLLM高性能推理
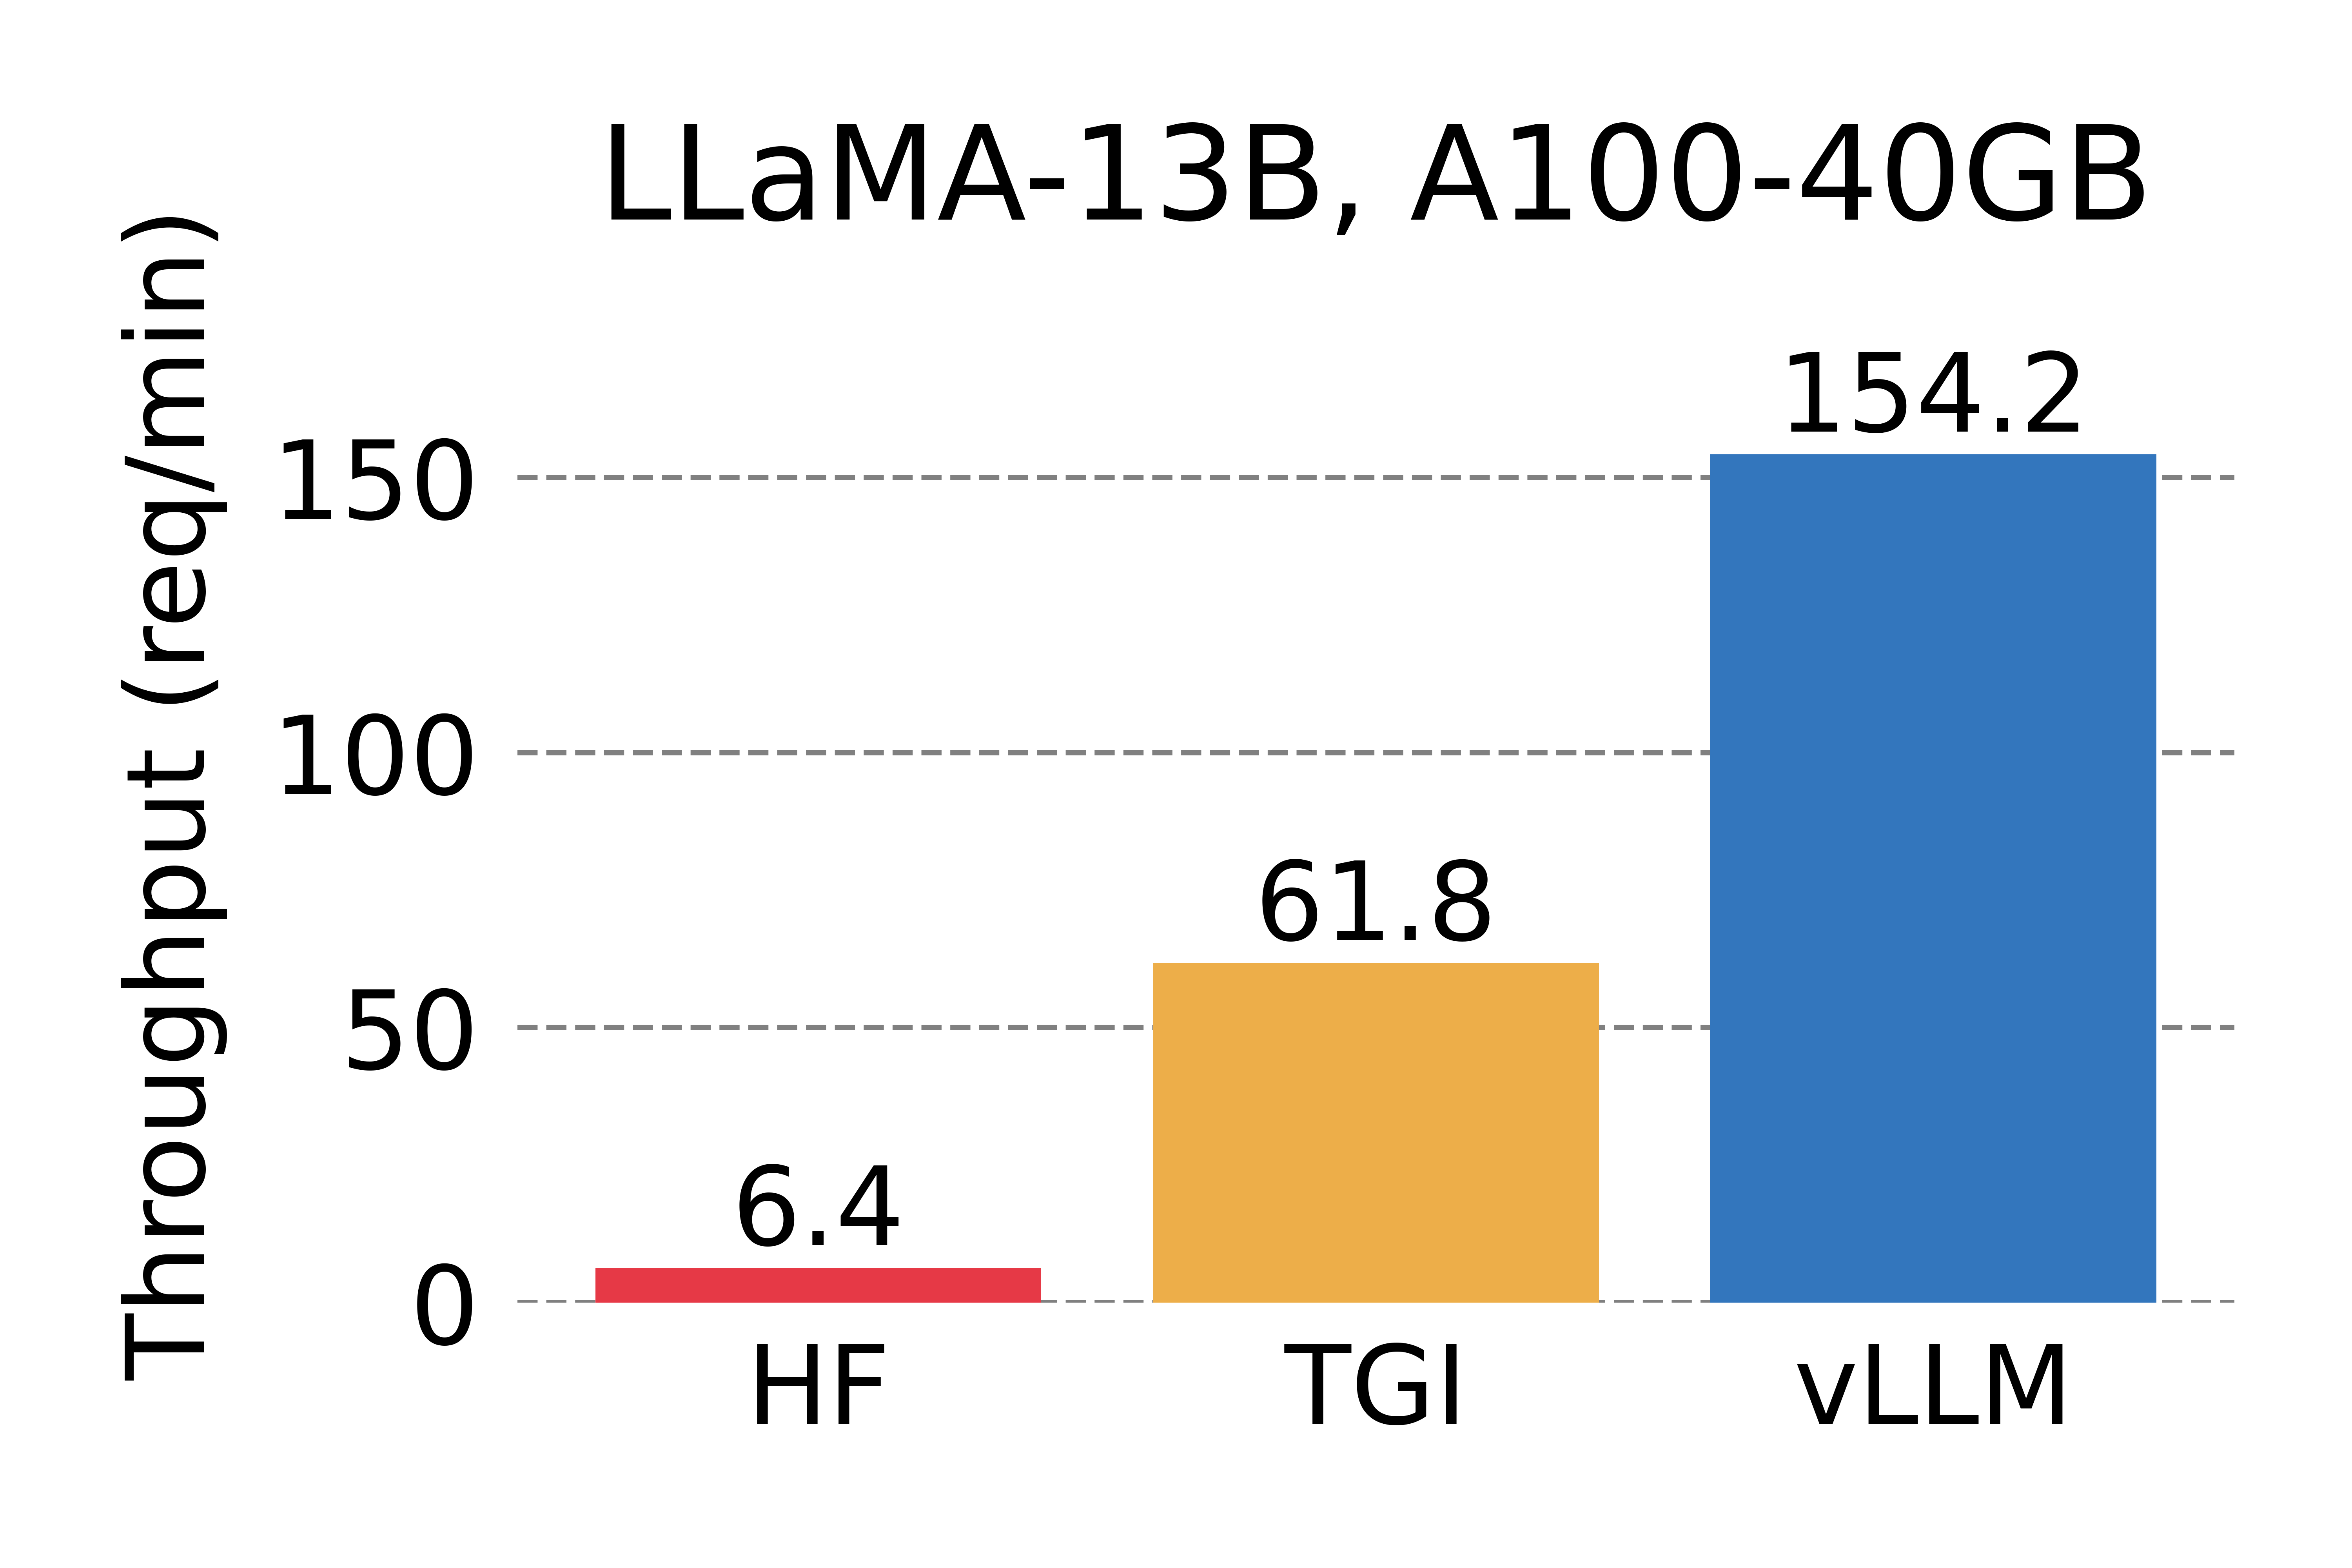 vLLM 吞吐量对比:A100 GPU
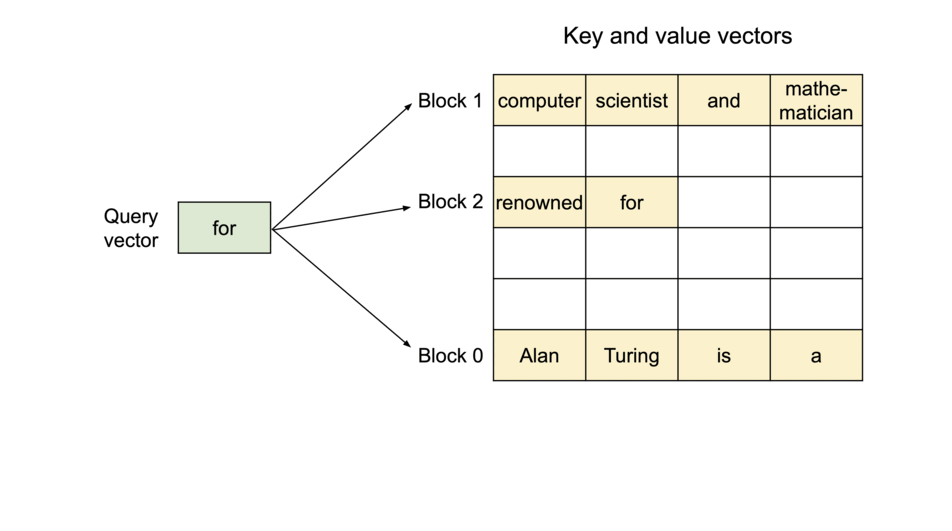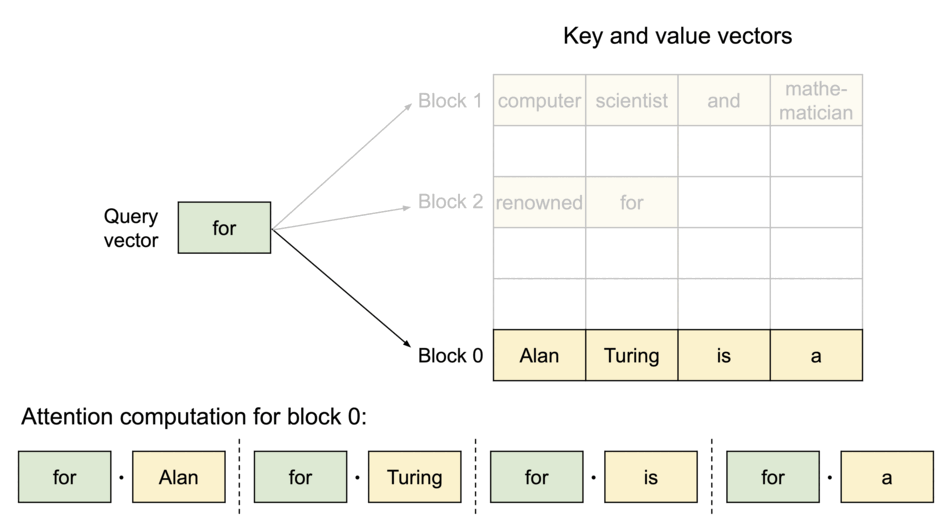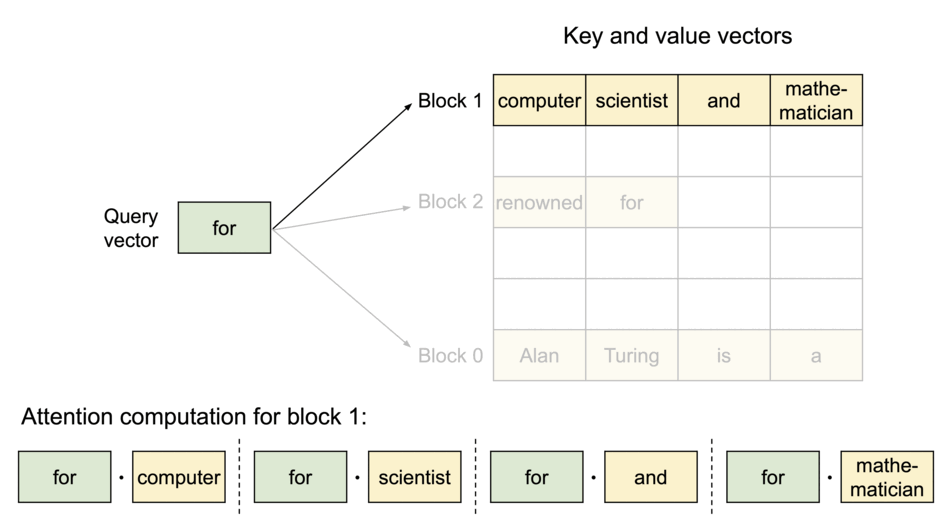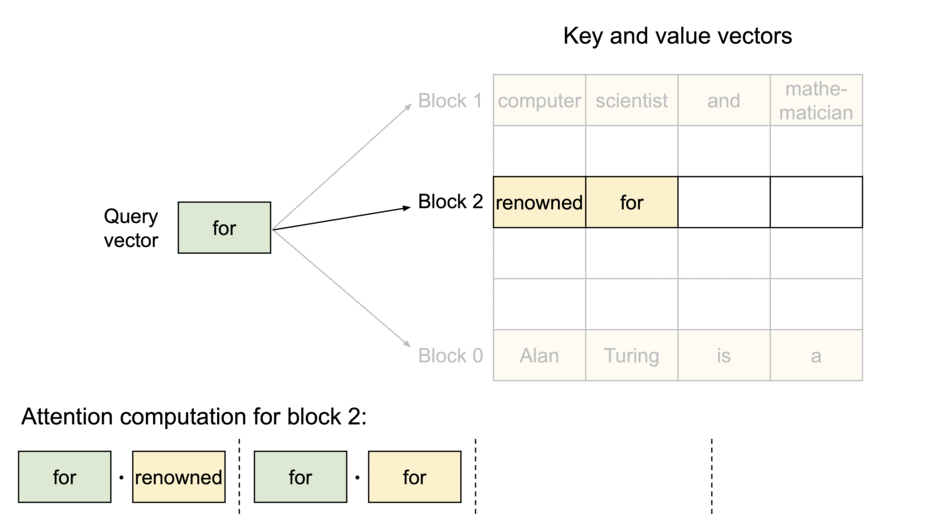 PagedAttention:KV Cache 分块存储
from vllm import LLM, SamplingParams

# 加载模型
llm = LLM(
    model="meta-llama/Llama-2-7b-chat-hf",
    tensor_parallel_size=1,  # GPU数量
    gpu_memory_utilization=0.9
)

# 采样参数
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.9,
    max_tokens=512
)

# 批量推理
prompts = ["你好", "介绍一下人工智能"]
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
print(output.outputs[0].text)vLLM核心优化
| 技术 | 说明 |
|---|---|
| PagedAttention | 分块管理 KV Cache,减少预留与碎片浪费;不能等同于 GPU 总显存利用率 |
| Continuous Batching | 动态批处理,提升吞吐 |
| Tensor Parallelism | 多GPU并行 |
| Prefix Caching | 缓存共享前缀 |
| Copy-on-Write | 并行采样共享 Prompt KV Cache |
如何解读性能证据:vLLM 早期论文与博客的吞吐提升对应当时硬件、请求长度、采样和基线实现。比较新版本时,固定模型、输入/输出长度分布、并发与延迟约束,用满足 SLO 的完成请求数或输出 token/s 衡量有效吞吐;不直接复用历史倍数。
长上下文服务:前缀缓存解决哪一段耗时
2026-10-08 官方文档核验。 vLLM Automatic Prefix Caching复用共享前缀的 KV,减少重复 prefill;它不直接加速生成新 token 的 decode。因此“长文档反复提问”和“短输入、长答案”应分开压测,不能用前者的缓存收益承诺后者的吞吐。
工程上先把稳定且允许复用的上下文放在前面,动态问题放在后面,保持实际 token 前缀一致;语义相同但序列不同不代表可命中。模型、适配器、模板或媒体处理变化时,按引擎规则隔离缓存。
最小对照是同一负载下的冷缓存、重复前缀热缓存和独立前缀三组:同时记录缓存命中/复用 token、P95 TTFT、TPOT、排队和显存。只有 TTFT 降而 TPOT 不变属于预期结果;命中高但总耗时没降时,检查解码、排队或媒体阶段是否占主导。此处未部署 vLLM,latest 文档是核验日快照,项目应锁定实际 release。
💻 本地部署
llama.cpp部署
下面按 官方构建文档使用 CMake,需 Git、编译器、CMake 和转换脚本的 Python 依赖。先固定 commit;GPU 后端需按设备增加选项。未在本机下载模型或构建运行。
# 1. 克隆并编译
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build
cmake --build build --config Release -j 4

# 2. 转换模型为GGUF格式
python convert_hf_to_gguf.py /path/to/model --outfile model.gguf

# 3. 量化
./build/bin/llama-quantize model.gguf model-q4_k_m.gguf Q4_K_M

# 4. 运行推理
./build/bin/llama-cli -m model-q4_k_m.gguf -p "你好" -n 128GGUF量化级别
| 量化类型 | 大小(7B) | 质量 | 推荐 |
|---|---|---|---|
| Q2_K | ~2.5GB | 较差 | 极限压缩 |
| Q4_K_M | ~4GB | 良好 | ✅ 推荐 |
| Q5_K_M | ~5GB | 很好 | 精度优先 |
| Q8_0 | ~7GB | 相对低位宽通常更接近原模型,仍需实测 | 有较多内存预算 |
Ollama快速部署
# 按操作系统从 https://ollama.com/download 安装 Ollama

# 运行模型
ollama run llama2

# 或使用自定义模型
ollama create mymodel -f Modelfile
ollama run mymodel✂️ 模型剪枝
结构化剪枝
结构化剪枝移除整行、通道、head 或层,并改变计算形状。下面保留的是非结构化置零示例:l1_unstructured 不会自动缩小稠密矩阵,普通内核未必加速。部署收益需要稀疏内核支持或改成实际结构裁剪,并复测质量。
import torch
import torch.nn.utils.prune as prune

def prune_model(model, amount=0.3):
    """对模型进行剪枝"""
    for name, module in model.named_modules():
        if isinstance(module, torch.nn.Linear):
            prune.l1_unstructured(module, name='weight', amount=amount)
            prune.remove(module, 'weight')
return model知识蒸馏
下面仅展示温度缩放的分布匹配;要求师生词表/位置对齐,teacher 应冻结并停止梯度。实际序列训练还需屏蔽 padding,按有效 token 归一化,通常组合监督损失;不同 tokenizer 不能直接逐词表 KL。
import torch.nn.functional as F

# 教师模型(大模型)
teacher = AutoModelForCausalLM.from_pretrained("large_model")

# 学生模型(小模型)
student = AutoModelForCausalLM.from_pretrained("small_model")

# 蒸馏损失
def distillation_loss(student_logits, teacher_logits, temperature=2.0):
    soft_targets = F.softmax(teacher_logits / temperature, dim=-1)
    soft_predictions = F.log_softmax(student_logits / temperature, dim=-1)
return F.kl_div(soft_predictions, soft_targets, reduction='batchmean') * temperature**2📊 推理框架对比
| 框架 | 特点 | 适用场景 |
|---|---|---|
| vLLM | PagedAttention,高吞吐 | 生产服务 |
| TGI | HuggingFace官方 | 企业部署 |
| llama.cpp | CPU推理,GGUF格式 | 本地/边缘 |
| Ollama | 开箱即用 | 快速体验 |
| TensorRT-LLM | NVIDIA优化 | 追求极致性能 |
容量预算与故障定位
先拆时间:端到端延迟 = 排队 + 输入处理 + prefill + decode + 输出传输。TTFT 包含哪些阶段要在报告里写清;高 QPS、低 TTFT 和长输出并不总能同时满足。
对普通 Transformer,KV 大小可粗算为 2 × 层数 × KV头数 × head维度 × 每元素字节 × 缓存token总数,再加分页/对齐等开销。GQA 的 KV 头数不能用 query 头数替代。
| 现象 | 检查方向 | 实验 |
|---|---|---|
| 并发升高、TTFT 急涨 | 排队与 prefill 争用 | 固定长度分布逐级加压,报 P50/P95/P99 |
| 长上下文才 OOM | KV、最大 batch token、临时工作区 | 压测最大上下文与输出上限组合 |
| 量化后慢了 | 内核支持、反量化、batch 太小 | 与同设备 BF16 基线比较质量和延迟 |
| tokens/s 高但用户等得久 | 聚合吞吐掩盖单请求速度 | 分开报系统吞吐、每请求 TPOT 与失败率 |
验收报告同时包含模型质量回归、输入/输出长度分布、流量模式、冷/热缓存、超时/拒绝率和峰值显存。对服务端设置队列、每请求 token 限额、超时与取消,并验证取消后释放 KV。示例代码未做性能实测,不作为容量承诺。
🔗 相关阅读
相关文章:
外部资源: