
CSDN 原文镜像
本文为作者 CSDN 博客的全文镜像,原文发布于 2026-07-30。为适配本站结构,补充了站内导读、元数据与来源说明,并清理代码高亮标记;原文观点与主体内容保留。
- 原文链接:https://blog.csdn.net/m0_63309778/article/details/163335924
- 站内分区:工程实践 / Playwright 自动化
站内导读:把浏览器动作与任务结果分开
先看定位、等待和浏览器上下文,再看如何封装 Agent 工具。完成点击并不意味着业务提交成功;任务结果需要页面或后端状态作为证据。
练习:在自己控制的测试页面改变加载时序与元素位置,比较稳定定位与固定延时;模拟提交响应丢失,避免自动重复提交。
前言
在传统爬虫中,我们通常使用 requests、httpx 或 curl 向服务器发送 HTTP 请求,然后解析返回的 HTML。
这种方式简单、快速、资源消耗低,但它有一个明显的问题:
它只能获取服务器直接返回的内容,无法像真实用户一样操作浏览器。
现代网站大量使用 React、Vue、Angular 等前端框架。很多页面打开时,服务器只返回一个简单的 HTML 外壳,真正的数据需要浏览器执行 JavaScript、调用后端接口后才能渲染出来。
除此之外,很多业务系统还包含:
- 登录状态与 Cookie;
- 动态 Token;
- iframe 嵌套页面;
- 弹窗和新标签页;
- 文件上传与下载;
- 懒加载列表;
- WebSocket 通信;
- 验证码和风控检测;
- 必须点击、滚动或输入后才加载的数据。
在这些场景下,仅使用 HTTP 请求库往往很难完成任务。
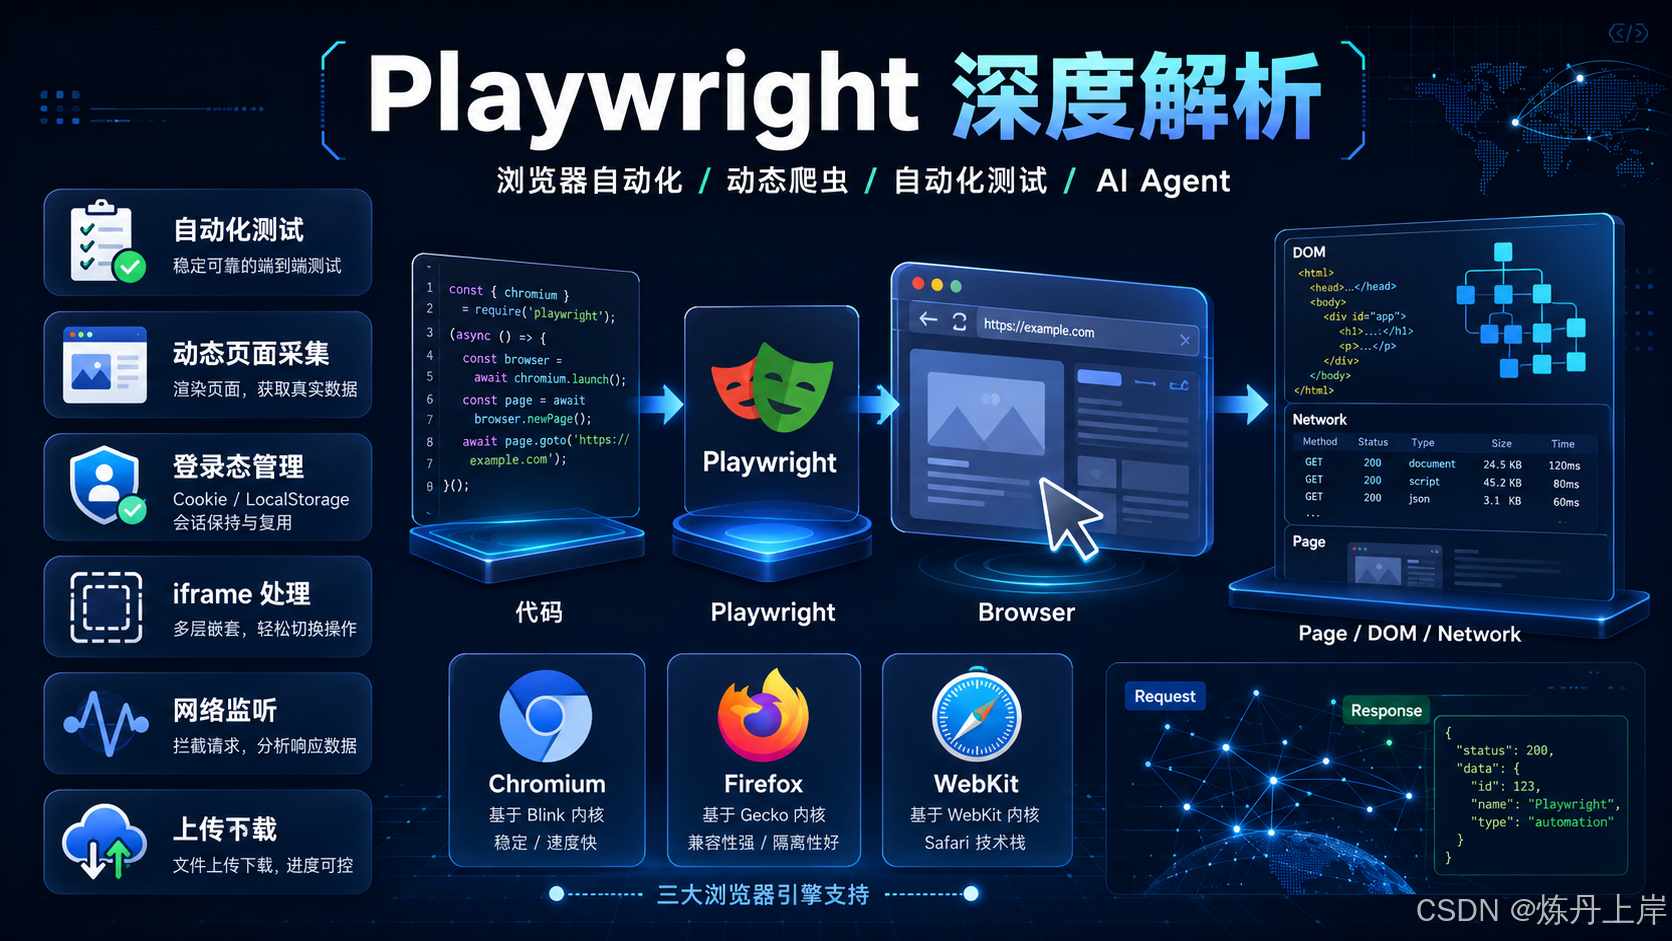
Playwright 正是为浏览器自动化而设计的工具。它能够通过统一的 API 控制 Chromium、Firefox 和 WebKit,并提供 TypeScript、JavaScript、Python、Java 和 .NET 等语言接口。目前 Playwright 不仅用于自动化测试,也广泛应用于浏览器脚本、动态网页采集和 AI Agent 浏览器操作。
一、Playwright 是什么
Playwright 是由 Microsoft 主导开发的开源浏览器自动化框架。
简单来说,Playwright 可以让程序像人一样操作浏览器,例如:
- 打开网站;
- 点击按钮;
- 输入账号密码;
- 登录系统;
- 切换页面;
- 操作 iframe;
- 等待数据加载;
- 监听接口请求;
- 上传和下载文件;
- 截图和录制视频;
- 提取页面中的数据。
它支持以下三类核心浏览器引擎:
| 浏览器引擎 | 常见浏览器 |
|---|---|
| Chromium | Chrome、Edge、Chromium |
| Firefox | Mozilla Firefox |
| WebKit | Safari 使用的浏览器引擎 |
Playwright 可以使用同一套 API 控制 Chromium、Firefox 和 WebKit,也可以运行 Chrome、Edge 等品牌浏览器,并支持模拟桌面端、平板和移动设备。
可以把 Playwright 理解为:
一套通过代码控制真实浏览器的工具。
它不是一个简单的 HTML 解析器,也不是普通的 HTTP 请求库,而是真正启动并控制浏览器进程。
二、Playwright 能做什么
2.1 Web 自动化测试
Playwright 最典型的用途是端到端测试,也就是 E2E 测试。
例如测试一个登录流程:
- 打开登录页面;
- 输入用户名;
- 输入密码;
- 点击登录;
- 验证是否进入首页;
- 验证用户名称是否正确显示。
from playwright.sync_api import sync_playwright, expect

def test_login():
with sync_playwright() as p:
browser = p.chromium.launch(headless=True)
page = browser.new_page()

page.goto("https://example.com/login")

page.get_by_label("用户名").fill("admin")
page.get_by_label("密码").fill("123456")
page.get_by_role("button", name="登录").click()

expect(page).to_have_url("https://example.com/home")
expect(page.get_by_text("欢迎回来")).to_be_visible()

browser.close()这段代码不是直接调用登录接口,而是完整模拟用户操作浏览器。
因此,它能够验证的不仅是接口,还包括:
- 页面是否正常渲染;
- 前后端是否正确联调;
- 按钮是否可点击;
- 表单校验是否生效;
- 页面跳转是否正确;
- 登录状态是否保存;
- 权限控制是否正确;
- 不同浏览器中是否表现一致。
Playwright Test 本身还提供测试执行器、断言、自动等待、失败重试、并行执行和 Trace 调试等能力。
2.2 动态网页数据采集
Playwright 也经常被用于动态爬虫。
假设一个网页的初始 HTML 只有:
<div id="app"></div>
<script src="/assets/index.js"></script>真正的数据由 JavaScript 请求接口后渲染。
使用 requests 获取到的可能只是空壳页面,而 Playwright 会启动浏览器、加载 JavaScript、执行接口请求,最终拿到完整页面。
from playwright.async_api import async_playwright

async def fetch_page():
async with async_playwright() as p:
browser = await p.chromium.launch(headless=True)

context = await browser.new_context(
locale="zh-CN",
viewport={<!-- -->"width": 1440, "height": 900}
)

page = await context.new_page()

await page.goto(
"https://example.com",
wait_until="domcontentloaded"
)

await page.locator(".result-list").wait_for()

items = await page.locator(".result-item").all_inner_texts()

print(items)

await context.close()
await browser.close()这类方式适合处理:
- JavaScript 动态渲染页面;
- 无限滚动列表;
- 点击“查看更多”后加载的数据;
- 登录后才能访问的页面;
- 需要切换筛选条件的页面;
- 数据位于 iframe 中的页面;
- 通过接口异步加载内容的页面。
不过,Playwright 的资源消耗通常比 requests 更高。因此,更合理的采集架构往往是:
普通静态页面
↓
requests / httpx 直接请求

动态页面或登录页面
↓
Playwright 获取登录状态、接口地址或页面内容

发现稳定数据接口
↓
尽可能切换回 HTTP 客户端批量请求也就是说:
Playwright 不一定要承担全部采集工作,它也可以负责打开页面、完成登录和发现接口,再把后续批量请求交给更轻量的 HTTP 客户端。
2.3 自动登录和登录状态保存
很多系统需要登录后才能访问。
Playwright 可以操作登录页面,也可以保存 Cookie、LocalStorage 等浏览器状态。
context = await browser.new_context()

page = await context.new_page()

await page.goto("https://example.com/login")

await page.get_by_label("账号").fill("admin")
await page.get_by_label("密码").fill("123456")
await page.get_by_role("button", name="登录").click()

await page.wait_for_url("**/home")

await context.storage_state(path="auth.json")下次执行时,可以直接加载登录状态:
context = await browser.new_context(
storage_state="auth.json"
)这样就不需要每次重新登录。
Playwright 的官方认证方案允许保存并复用已认证状态,从而减少重复登录并提高执行速度。需要注意的是,认证状态文件可能包含敏感 Cookie 和 Header,不应该提交到公开代码仓库。
2.4 操作 iframe
很多政务网站、企业系统和老旧平台都会使用 iframe。
页面结构可能是:
<html>
<body>
<iframe id="content-frame" src="/detail/content"></iframe>
</body>
</html>正文并不在主页面中,而在 iframe 里。
Playwright 可以通过 frame_locator 进入 iframe:
frame = page.frame_locator("#content-frame")

title = await frame.locator("h1").inner_text()
content = await frame.locator(".article-content").inner_text()Playwright 的 FrameLocator 专门用于定位 iframe,并继续查找 iframe 内部的元素。
这对动态采集非常重要。
例如有些网站的详情页实际上分为两层:
外层壳页面
└── iframe
└── 真正的正文页面如果直接在外层页面执行:
await page.locator("body").inner_text()拿到的可能是导航栏、菜单、版权信息和 iframe 周边文本,而不是正文。
更合理的方式是:
- 判断页面中是否存在 iframe;
- 找到当前激活的正文 iframe;
- 只在该 iframe 内提取正文;
- iframe 不存在时,再回退到主页面提取。
2.5 监听和拦截网络请求
Playwright 不只能操作 DOM,还可以监听浏览器发送的网络请求。
page.on(
"request",
lambda request: print(
"请求:",
request.method,
request.url
)
)

page.on(
"response",
lambda response: print(
"响应:",
response.status,
response.url
)
)这项能力在动态页面分析中非常实用。
例如页面上显示了一张列表,但 DOM 结构非常复杂。此时可以监听页面加载过程,找到真正返回 JSON 数据的接口:
async with page.expect_response(
lambda response: "/api/project/list" in response.url
) as response_info:
await page.get_by_role("button", name="查询").click()

response = await response_info.value
data = await response.json()相比直接从页面文本中提取,读取接口 JSON 通常更加稳定。
Playwright 还支持:
- 修改请求 Header;
- 阻止图片、字体和视频;
- Mock API 返回值;
- 修改接口响应;
- 监听 WebSocket;
- Mock WebSocket 通信;
- 模拟接口异常和超时。
Playwright 官方网络能力覆盖 HTTP、HTTPS 和 WebSocket 的监听、修改与模拟。
例如,采集时可以阻止图片加载:
async def handle_route(route):
resource_type = route.request.resource_type

if resource_type in {<!-- -->"image", "font", "media"}:
await route.abort()
else:
await route.continue_()

await page.route("**/*", handle_route)这样可以减少网络流量,但需要谨慎使用。有些页面会通过图片、字体或其他资源的加载结果判断页面状态,过度拦截可能导致页面逻辑异常。
2.6 文件上传与下载
Playwright 可以自动操作文件上传组件:
await page.get_by_label("上传文件").set_input_files(
"documents/report.pdf"
)也可以监听文件下载:
async with page.expect_download() as download_info:
await page.get_by_role("button", name="导出").click()

download = await download_info.value

await download.save_as(
f"downloads/{<!-- -->download.suggested_filename}"
)Playwright 会为下载事件创建对应的 Download 对象,可以获取文件名称、下载地址并保存文件。下载文件默认与产生它的 BrowserContext 生命周期相关。
因此,它非常适合:
- 自动下载报表;
- 自动导出 Excel;
- 上传标书或附件;
- 批量上传文档;
- 验证上传下载功能;
- 自动化处理后台管理系统。
2.7 截图、视频和 Trace
Playwright 可以对页面进行截图:
await page.screenshot(
path="page.png",
full_page=True
)也可以只截取某个元素:
await page.locator(".article-content").screenshot(
path="article.png"
)官方截图 API 支持全页面截图、指定区域截图和将图片读取为内存 Buffer。
除了截图,Playwright 还支持录制浏览器视频和 Trace。
Trace 可以记录:
- 每一步执行的操作;
- 操作前后的页面状态;
- DOM 快照;
- 网络请求;
- Console 日志;
- 页面截图;
- 操作耗时;
- 使用的 Locator;
- 错误发生的位置。
npx playwright test --trace on运行完成后可以打开 Trace:
npx playwright show-trace trace.zipTrace Viewer 是 Playwright 提供的可视化分析工具,特别适合排查 CI 环境中偶发失败的问题。
2.8 模拟不同设备和网络环境
Playwright 可以模拟:
- 手机和平板;
- 不同屏幕尺寸;
- 不同 User-Agent;
- 不同语言;
- 不同时区;
- 地理位置;
- 摄像头和麦克风权限;
- 深色模式;
- 离线状态;
- 自定义 HTTP Header。
context = await browser.new_context(
viewport={<!-- -->
"width": 390,
"height": 844
},
user_agent="Mozilla/5.0 ...",
locale="zh-CN",
timezone_id="Asia/Shanghai",
color_scheme="dark"
)这使 Playwright 不仅能测试桌面网页,还能验证移动端适配、国际化、权限和网络异常场景。浏览器和 BrowserContext 级别均可以配置设备模拟、网络和录制能力。
2.9 作为 AI Agent 的浏览器执行工具
随着 AI Agent 的发展,Playwright 也逐渐成为浏览器 Agent 的基础执行工具。
一个浏览器 Agent 的工作流程可能是:
用户提出任务
↓
大模型理解目标
↓
读取当前页面结构
↓
判断下一步操作
↓
调用 Playwright 点击、输入或跳转
↓
获取新的页面状态
↓
继续推理和执行例如用户说:
登录后台,找到昨天失败的任务,把错误日志整理出来。
Agent 可以通过 Playwright:
- 打开系统;
- 填写账号密码;
- 进入任务中心;
- 选择时间范围;
- 筛选失败任务;
- 打开任务详情;
- 读取错误信息;
- 返回总结。
Microsoft 目前提供了 Playwright MCP Server,使大模型能够通过 Model Context Protocol 调用浏览器自动化能力。官方实现主要使用结构化的可访问性快照帮助模型理解页面,而不是完全依赖截图和视觉识别。
三、Playwright 的核心对象模型
学习 Playwright 时,最重要的是理解以下几个核心对象:
Playwright
├── Chromium
├── Firefox
└── WebKit
↓
Browser
↓
BrowserContext
↓
Page
↓
Frame / Locator3.1 Playwright
Playwright 是整个框架的入口。
async with async_playwright() as p:
browser = await p.chromium.launch()这里的 p 就是 Playwright 实例。
它提供三个主要的浏览器类型:
p.chromium
p.firefox
p.webkit3.2 Browser
Browser 表示一个浏览器进程。
browser = await p.chromium.launch(
headless=True
)常见配置包括:
browser = await p.chromium.launch(
headless=False,
slow_mo=500
)其中:
headless=True:无界面运行;headless=False:显示浏览器界面;slow_mo=500:每一步操作放慢 500 毫秒。
在开发和排查问题时,可以使用有界面模式;在服务器和生产环境中,通常使用无头模式。
3.3 BrowserContext
BrowserContext 是 Playwright 非常重要的设计。
可以把它理解为一个独立的无痕浏览器环境。
每个 BrowserContext 都有自己独立的:
- Cookie;
- LocalStorage;
- SessionStorage;
- 页面;
- 权限;
- User-Agent;
- 网络规则;
- 登录状态。
context_1 = await browser.new_context()
context_2 = await browser.new_context()即使它们共用同一个 Browser 进程,也不会共享登录状态。
Playwright 使用 BrowserContext 实现测试隔离,每个测试可以拥有独立的浏览器上下文,从而降低状态污染和级联失败。
这意味着执行批量任务时,不一定要为每个任务都启动一个新的浏览器进程。
更常见的方式是:
一个 Browser
├── Context A:账号 A
├── Context B:账号 B
└── Context C:游客状态这样既实现状态隔离,也能减少频繁启动浏览器的成本。
3.4 Page
Page 表示浏览器中的一个标签页或弹窗页面。
page = await context.new_page()一个 BrowserContext 可以包含多个 Page。
page_1 = await context.new_page()
page_2 = await context.new_page()Playwright 中的 Page 可以:
- 打开 URL;
- 获取 HTML;
- 执行 JavaScript;
- 操作页面元素;
- 监听请求;
- 监听弹窗;
- 监听下载;
- 截图;
- 获取 Console 日志。
官方将 Page 定义为 BrowserContext 中的一个标签页或弹出窗口。
3.5 Locator
Locator 是 Playwright 元素定位机制的核心。
login_button = page.get_by_role(
"button",
name="登录"
)这里的 login_button 不是某一个固定 DOM 节点,而是一种“如何找到这个元素”的描述。
执行操作时,Playwright 会重新查找当前最新的 DOM 元素:
await login_button.hover()
await login_button.click()即使两次操作之间页面发生了重新渲染,Playwright 也会在每次操作前重新解析 Locator,而不是一直引用旧的 DOM 节点。
这对 React、Vue 等动态更新 DOM 的页面非常重要。
四、Playwright 的底层工作原理
4.1 整体调用链路
Playwright 的工作过程可以抽象为:
开发者编写:
await page.get_by_role(
"button",
name="登录"
).click()背后会经历以下过程:
- Python 客户端接收调用;
- 将操作转换为 Playwright 协议消息;
- Playwright Driver 接收消息;
- Driver 将操作发送给对应浏览器;
- 浏览器查找元素并执行点击;
- 浏览器产生页面、网络和事件变化;
- Driver 将结果返回给 Python 客户端;
- Python 代码继续执行。
以 Playwright Python 为例,官方代码仓库说明,Python 客户端通过管道向内置的 Node.js Driver 发送 JSON 消息,通信协议由 Playwright 上游协议定义。
因此,Python 版本并不是完全用 Python 重新实现了一套浏览器控制核心。
更准确的理解是:
Python API
↓
Playwright Driver
↓
浏览器Java 和 .NET 等语言版本也采用类似的语言绑定与 Driver 通信方式。
4.2 Playwright 并不只是 CDP 的简单封装
CDP 是 Chrome DevTools Protocol,也就是 Chromium 系浏览器使用的调试协议。
Playwright 确实支持通过 connect_over_cdp 连接现有 Chromium 浏览器:
browser = await p.chromium.connect_over_cdp(
"http://localhost:9222"
)但 CDP 连接仅适用于 Chromium 浏览器。Playwright 官方还明确指出,通过 CDP 建立的连接,相比 Playwright 自己的协议连接功能完整度更低;复杂功能更适合使用 Playwright 原生连接方式。
因此,不能简单地把 Playwright 理解为:
在 CDP 外面封装了一层 API。
更准确的说法是:
Playwright 提供统一的上层 API 和自己的通信协议,再针对 Chromium、Firefox 和 WebKit 实现浏览器控制能力。
4.3 事件驱动模型
浏览器中的很多行为不是同步发生的。
例如点击按钮后,可能产生:
- 页面跳转;
- 弹出新窗口;
- 文件下载;
- 接口请求;
- iframe 加载;
- WebSocket 消息;
- DOM 更新。
因此 Playwright 大量使用事件驱动机制。
例如等待新标签页:
async with context.expect_page() as page_info:
await page.get_by_text("打开详情").click()

new_page = await page_info.value等待下载:
async with page.expect_download() as download_info:
await page.get_by_text("下载").click()

download = await download_info.value等待接口响应:
async with page.expect_response(
lambda response: "/api/detail" in response.url
) as response_info:
await page.get_by_text("查看详情").click()

response = await response_info.value这里有一个重要原则:
先注册等待事件,再触发页面操作。
错误写法:
await page.get_by_text("下载").click()
download = await page.wait_for_event("download")点击完成时,下载事件可能已经发生,后续等待就可能超时。
正确写法:
async with page.expect_download() as download_info:
await page.get_by_text("下载").click()五、Playwright 为什么比传统自动化脚本更稳定
5.1 自动等待
传统浏览器脚本中经常出现大量固定等待:
await page.click("#submit")
await asyncio.sleep(3)问题在于:
- 网络快时,浪费三秒;
- 网络慢时,三秒仍然不够;
- CI 环境负载变化时容易偶发失败。
Playwright 在执行点击等操作之前,会自动检查元素状态。
以点击为例,Playwright 通常会检查:
- 元素是否已经找到;
- 元素是否可见;
- 元素位置是否稳定;
- 元素是否启用;
- 元素是否能够接收点击事件;
- 元素是否被其他弹窗或遮罩层挡住。
只有满足操作条件后,Playwright 才会执行点击。
await page.get_by_role(
"button",
name="提交"
).click()这行代码背后实际上包含了查找、等待、状态检查、滚动和点击等过程。
5.2 自动重试断言
Playwright 的 Web First Assertions 也会自动重试。
expect(page.locator(".status")).to_have_text(
"处理完成"
)如果页面暂时显示的是:
处理中Playwright 不会立即判定失败,而是会在超时时间内持续检查,直到:
处理完成或者等待超时。
Playwright 官方断言支持对元素可见性、文本、属性、状态、URL 和响应等条件进行自动重试。
5.3 Locator 会重新解析元素
传统代码可能先找到 DOM 元素,然后长期持有这个引用。
但 React 或 Vue 重新渲染后,原来的元素可能已经被删除并替换。
Playwright 推荐使用 Locator:
button = page.get_by_role(
"button",
name="提交"
)

await button.hover()
await button.click()每次真正执行操作时,Locator 都会根据当前页面重新寻找元素,从而减少旧元素引用导致的问题。
六、Playwright 常见定位方式
Playwright 支持多种元素定位方式。
6.1 根据角色定位
page.get_by_role(
"button",
name="登录"
)适合按钮、链接、输入框、复选框等标准元素。
6.2 根据 Label 定位
page.get_by_label("用户名")
page.get_by_label("密码")适合表单元素。
6.3 根据文本定位
page.get_by_text("查看详情")6.4 根据 Placeholder 定位
page.get_by_placeholder("请输入关键词")6.5 根据 Test ID 定位
page.get_by_test_id("submit-button")前端页面:
<button data-testid="submit-button">
提交
</button>6.6 CSS 选择器
page.locator(".article-list .article-item")6.7 XPath
page.locator(
"xpath=//button[contains(text(),'提交')]"
)虽然 XPath 能力很强,但通常不应该优先使用过长的绝对 XPath:
/html/body/div[2]/div[3]/div/button页面结构稍微变化,定位就可能失效。
Playwright 官方最佳实践建议优先使用用户可感知的属性和明确契约,例如 Role、Label、Text 和 Test ID,而不是依赖脆弱的 DOM 层级。
七、一个相对完整的 Python 示例
下面使用 Playwright 完成:
- 启动浏览器;
- 创建独立上下文;
- 打开页面;
- 监听接口;
- 点击查询;
- 提取列表;
- 保存截图;
- 捕获异常;
- 释放资源。
import asyncio
from pathlib import Path

from playwright.async_api import (
async_playwright,
TimeoutError as PlaywrightTimeoutError,
)

async def collect_data() -> list[dict[str, str]]:
output_dir = Path("artifacts")
output_dir.mkdir(parents=True, exist_ok=True)

async with async_playwright() as playwright:
browser = await playwright.chromium.launch(
headless=True
)

context = await browser.new_context(
locale="zh-CN",
viewport={<!-- -->
"width": 1440,
"height": 900,
},
)

page = await context.new_page()

try:
await page.goto(
"https://example.com/projects",
wait_until="domcontentloaded",
timeout=30_000,
)

keyword_input = page.get_by_placeholder(
"请输入项目名称"
)

await keyword_input.fill("人工智能")

async with page.expect_response(
lambda response: (
"/api/project/list" in response.url
and response.status == 200
),
timeout=20_000,
) as response_info:
await page.get_by_role(
"button",
name="查询",
).click()

response = await response_info.value
response_data = await response.json()

await page.locator(
".project-list"
).wait_for(
state="visible",
timeout=20_000,
)

rows = page.locator(".project-item")
count = await rows.count()

results: list[dict[str, str]] = []

for index in range(count):
row = rows.nth(index)

title = await row.locator(
".project-title"
).inner_text()

date = await row.locator(
".project-date"
).inner_text()

results.append(
{<!-- -->
"title": title.strip(),
"date": date.strip(),
}
)

await page.screenshot(
path=output_dir / "result.png",
full_page=True,
)

print(
"接口返回数据量:",
len(response_data.get("data", [])),
)

return results

except PlaywrightTimeoutError:
await page.screenshot(
path=output_dir / "timeout.png",
full_page=True,
)
raise RuntimeError("页面操作超时")

finally:
await context.close()
await browser.close()

if __name__ == "__main__":
data = asyncio.run(collect_data())

for item in data:
print(item)八、Playwright 在生产环境中的架构设计
直接写一个 Playwright 脚本并不难,难的是将它建设成稳定的生产系统。
推荐将系统拆分为以下几层:
8.1 Browser 不要频繁启动
错误方式:
每来一个任务
↓
启动浏览器
↓
执行任务
↓
关闭浏览器浏览器启动属于相对昂贵的操作。
更合理的方式是:
Worker 启动
↓
创建 Browser
↓
任务到达
↓
创建 BrowserContext
↓
执行任务
↓
关闭 BrowserContext
↓
复用 Browser但是 Browser 也不能永久运行,需要配置:
- 最大任务数;
- 最大存活时间;
- 内存阈值;
- 页面崩溃检测;
- Browser 重启机制。
8.2 任务之间使用 BrowserContext 隔离
不同用户和任务不应该共用同一个 Context,否则可能产生:
- Cookie 串用;
- 登录状态污染;
- LocalStorage 污染;
- 页面残留;
- 权限相互影响。
推荐:
Browser:进程级复用
BrowserContext:任务级或账号级隔离
Page:具体页面操作8.3 设置分层超时
不要只有一个总超时。
建议分别设置:
任务总超时
├── 页面打开超时
├── 元素等待超时
├── 接口等待超时
├── 下载超时
└── 单步操作超时例如:
context.set_default_timeout(10_000)
context.set_default_navigation_timeout(30_000)任务调度层还应设置更高层的总超时,避免整个 Worker 被某个任务长期占用。
8.4 做好可观测性
生产环境中的 Playwright 任务失败时,只保存一条异常日志通常不够。
至少应该保存:
- 当前 URL;
- 任务 ID;
- 页面标题;
- 异常堆栈;
- 页面截图;
- 页面 HTML;
- Console 日志;
- 失败请求;
- Trace;
- 浏览器版本;
- 脚本版本;
- 账号或会话标识。
这样才能回答:
是页面改版了、接口失败了、登录失效了、元素被遮挡了,还是浏览器崩溃了?
8.5 设计任务状态机
一个 Playwright 任务通常不是简单的成功或失败。
可以设计为:
PENDING
↓
RUNNING
↓
LOGIN_REQUIRED
↓
COLLECTING
↓
PARSING
↓
SUCCESS异常状态包括:
TIMEOUT
AUTH_EXPIRED
PAGE_CHANGED
NETWORK_ERROR
BROWSER_CRASHED
CAPTCHA_REQUIRED
FAILED通过明确的状态机,可以决定哪些错误能够自动重试,哪些错误需要人工介入。
九、Playwright 的局限性
Playwright 很强,但并不是万能的。
9.1 资源消耗较大
每个浏览器进程和页面都需要消耗:
- CPU;
- 内存;
- 文件描述符;
- 网络连接;
- 临时磁盘空间。
如果同时启动几百个浏览器实例,服务器很容易出现资源耗尽。
因此,需要限制:
- Worker 数量;
- Browser 数量;
- Context 数量;
- Page 数量;
- 单任务并发;
- 单浏览器存活时间。
9.2 无法天然解决验证码
Playwright 可以操作验证码页面,但它并不能天然解决:
- 图片验证码;
- 滑块验证码;
- 短信验证码;
- 扫码登录;
- 行为验证;
- 人机验证。
遇到这些场景时,通常需要:
- 人工介入;
- 官方接口;
- 合法授权的账号体系;
- 验证码识别服务;
- 会话状态复用。
9.3 不能天然绕过所有反爬系统
使用真实浏览器不等于完全无法被识别。
网站可能综合判断:
- IP;
- Cookie;
- 浏览器指纹;
- 请求频率;
- 鼠标轨迹;
- 页面停留时间;
- 账号行为;
- TLS 指纹;
- Header;
- 访问路径;
- 浏览器自动化特征。
因此,Playwright 的定位应该是:
浏览器自动化工具,而不是万能的风控绕过工具。
使用时也应遵守目标网站的服务条款、数据授权范围和相关法律法规。
9.4 页面改版仍然会导致脚本失效
如果页面按钮名称、DOM 结构或业务流程发生变化,自动化脚本仍然可能失败。
稳定性需要依赖:
- 更可靠的 Locator;
- 页面版本监控;
- 多种提取策略;
- 失败截图;
- Trace;
- 结构变化检测;
- 回退逻辑;
- 自动化回归测试。
十、Playwright、HTTP 请求和人工浏览器如何选择
| 场景 | 推荐方案 |
|---|---|
| 静态 HTML 页面 | requests、httpx |
| 已知并且稳定的 JSON 接口 | 直接请求接口 |
| JavaScript 动态渲染页面 | Playwright |
| 必须登录才能访问 | Playwright 或复用登录 Cookie |
| iframe 页面 | Playwright |
| 需要点击、输入、滚动 | Playwright |
| 高并发批量接口采集 | HTTP 客户端 |
| 自动化回归测试 | Playwright Test |
| 自动下载后台报表 | Playwright |
| AI Agent 操作网页 | Playwright、Playwright MCP |
| 复杂验证码或人工审批 | 人机协同 |
一个成熟系统通常不会只使用一种方式。
更合理的组合是:
Playwright
负责登录、交互、页面分析和接口发现

HTTP 客户端
负责稳定接口的高并发数据请求

HTML 解析器
负责结构化提取

任务队列
负责并发、重试和调度

对象存储
负责保存截图、HTML、下载文件和 Trace十一、最佳实践总结
在实际项目中使用 Playwright,可以重点遵循以下原则。
第一,优先使用 Locator,不要长期持有旧的 DOM ElementHandle。
第二,优先使用 Role、Label、Text 和 Test ID,尽量避免脆弱的绝对 XPath。
第三,减少固定 sleep,依赖 Locator 自动等待、接口事件和明确的页面状态。
第四,一个 Browser 可以复用,但不同任务尽量使用独立 BrowserContext。
第五,动态页面优先分析网络接口,不要所有数据都从页面文本中硬解析。
第六,出现 iframe 时,应明确进入目标 iframe,而不是直接扫描整个外层页面。
第七,等待下载、弹窗和接口时,要先注册事件,再触发操作。
第八,生产环境必须保存截图、HTML、Console、网络错误和 Trace。
第九,对浏览器、Context、Page 和任务设置资源上限与超时。
第十,不要把 Playwright 当作万能反爬工具,应在授权和合规范围内使用。
十二、结语
Playwright 的价值并不只是“自动点击网页”。
它真正解决的是:
如何让程序稳定地进入一个真实浏览器环境,并观察、操作和验证现代 Web 应用。
从能力上看,Playwright 横跨了多个领域:
自动化测试
动态网页采集
后台流程自动化
文件上传下载
接口调试与 Mock
页面截图与录制
浏览器 Agent
AI 自动化执行它的核心优势来自几个关键设计:
- 统一控制 Chromium、Firefox 和 WebKit;
- 使用 BrowserContext 实现会话隔离;
- 使用 Locator 应对动态 DOM;
- 通过自动等待减少脚本偶发失败;
- 通过网络监听获取页面背后的真实数据;
- 通过 Trace 提升自动化任务的可调试性;
- 通过 MCP 等方式成为 AI Agent 的浏览器执行层。
如果只是采集一个简单的静态页面,使用 Playwright 可能显得过重。
但当你面对登录系统、动态渲染、iframe、复杂交互、文件下载、浏览器测试或 AI Agent 操作网页时,Playwright 往往是目前最值得掌握的浏览器自动化工具之一。