
CSDN 原文镜像
本文为作者 CSDN 博客的全文镜像,原文发布于 2026-08-04。为适配本站结构,补充了站内导读、元数据与来源说明,并清理代码高亮标记;原文观点与主体内容保留。
- 原文链接:https://blog.csdn.net/m0_63309778/article/details/163476127
- 站内分区:工程实践 / 异步任务架构
站内导读:把异步任务接到 RAG 与 Agent
重点阅读任务入队、Worker 执行和结果回查。把它映射到文档解析、索引构建或 Agent 长任务时,应分别记录业务任务状态与消息投递状态。
练习:让 Worker 在写入结果后、确认消息前退出,检查重试是否造成重复业务动作;再验证取消、超时和重启后的状态查询。
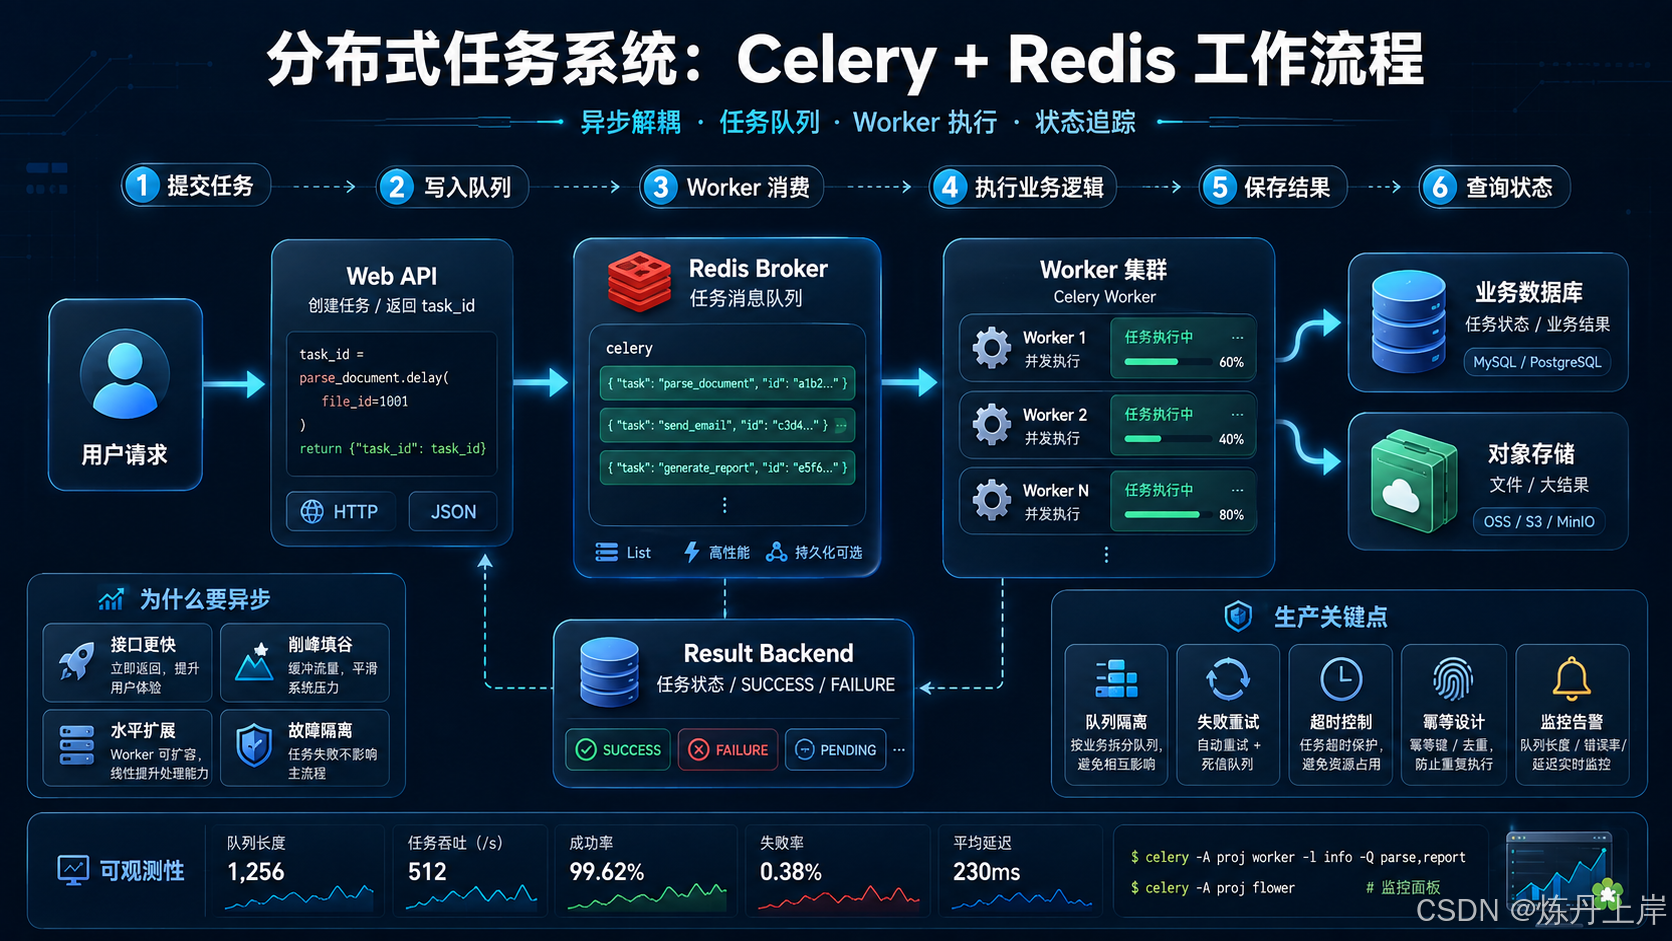
前言
在普通 Web 系统中,用户发送请求,服务端完成处理,然后返回结果。
用户请求
↓
Web 服务执行
↓
返回结果对于登录、查询、参数校验这类短操作,这种同步模式没有问题。
但当系统中出现以下任务时,同步执行就不合适了:
- 解析几百页的 PDF;
- 执行 OCR 或图片识别;
- 调用大模型生成内容;
- 批量发送邮件;
- 抓取大量网页;
- 生成 Excel、Word 或 PDF;
- 建立 RAG 向量索引;
- 执行定时数据同步。
这些任务可能需要几十秒,甚至几分钟。如果一直占用 HTTP 请求,容易出现超时、连接断开、服务卡顿等问题。
因此,我们通常会把耗时任务从 Web 服务中拆出去:
用户提交任务
↓
Web 服务记录任务
↓
将任务放入消息队列
↓
立即返回任务 ID

后台 Worker
↓
获取任务
↓
执行任务
↓
更新任务状态Celery + Redis 就是 Python 项目中非常常见的一套异步任务解决方案。
一、为什么需要分布式任务系统
1. 同步执行的问题
假设用户上传一个 300 页的 PDF,解析需要 5 分钟。
如果直接在接口中执行:
def upload_and_parse(file):
save_file(file)
result = parse_pdf(file)
return result整个请求会持续等待 5 分钟。
这期间可能出现:
- Nginx 请求超时;
- 浏览器连接断开;
- Web 进程长期被占用;
- 其他用户请求变慢;
- 任务执行失败后难以重试;
- 用户不知道任务进行到哪一步。
更严重的是,如果大量用户同时提交任务,Web 服务很快会被拖垮。
2. 异步执行的思路
异步任务的核心是:
Web 服务只负责接收任务,不负责完成所有耗时计算。
处理流程变成:
用户上传文件
↓
Web 服务保存文件
↓
创建一条任务记录
↓
将任务发送到队列
↓
返回任务 ID后台 Worker 再慢慢处理:
Worker 获取任务
↓
下载文件
↓
解析文档
↓
保存结果
↓
更新任务状态这样做有几个明显好处:
Web 接口响应更快
用户提交任务后,可以很快收到响应:
{<!-- -->
"taskId": 10001,
"status": "QUEUED"
}用户不需要一直保持连接。
可以水平扩容
任务变多时,可以增加 Worker:
一个 Worker
↓
三个 Worker
↓
十个 Worker多个 Worker 可以共同消费同一个任务队列。
可以隔离不同类型任务
例如:
文档解析 Worker
OCR Worker
爬虫 Worker
邮件 Worker
大模型 Worker爬虫服务崩溃,不一定影响文档解析和用户登录。
可以重试和监控
任务失败后可以自动重试,也可以记录:
- 当前状态;
- 执行进度;
- 失败原因;
- 重试次数;
- 开始时间;
- 完成时间。
二、Celery 和 Redis 分别是什么
1. Celery 是什么
Celery 是 Python 中常用的分布式任务队列框架。
它主要负责:
- 定义任务;
- 发送任务;
- 调度任务;
- Worker 执行任务;
- 失败重试;
- 定时任务;
- 任务状态管理;
- 多任务编排。
例如定义一个 Celery 任务:
from celery import Celery

app = Celery("demo")

@app.task
def add(x, y):
return x + y提交任务:
result = add.delay(1, 2)这里的 delay() 并不会在当前 Web 进程中直接执行 add()。
它会把任务发送到消息队列,等待 Worker 执行。
2. Redis 是什么
Redis 是一个高性能内存数据存储系统。
在 Celery 中,Redis 常见有两个作用。
作为 Broker
Broker 可以理解为任务中转站。
Web 服务
↓
Redis Broker
↓
Celery WorkerWeb 服务把任务消息写入 Redis,Worker 再从 Redis 读取任务。
作为 Result Backend
Result Backend 用来保存任务状态和返回结果。
Worker 执行完成
↓
Redis Result Backend
↓
系统查询任务状态因此需要区分:
Broker:任务要交给谁执行

Result Backend:任务执行得怎么样常见配置:
app = Celery(
"demo",
broker="redis://localhost:6379/0",
backend="redis://localhost:6379/1",
)这里:
Redis DB 0:保存待执行任务
Redis DB 1:保存任务状态和结果三、Celery + Redis 的核心组件
一套完整的 Celery 系统,主要有以下几个角色。
1. Producer
Producer 是任务生产者。
它可以是:
- FastAPI;
- Django;
- Flask;
- Python 脚本;
- 另一个 Celery 任务;
- 定时任务调度器。
Producer 的职责是:
创建任务消息
↓
发送到 Broker2. Broker
Broker 负责保存和转发任务消息。
它位于 Producer 和 Worker 之间,使二者解耦。
Producer 不需要知道:
- 哪个 Worker 会执行任务;
- Worker 当前是否空闲;
- Worker 部署在哪台服务器;
- 任务什么时候开始。
它只需要把任务成功交给 Broker。
3. Worker
Worker 是真正执行任务的进程。
启动示例:
celery -A app worker --loglevel=INFOWorker 启动后会:
- 连接 Redis;
- 监听任务队列;
- 获取任务消息;
- 找到对应任务函数;
- 执行业务逻辑;
- 保存结果;
- 确认任务完成。
4. Result Backend
Result Backend 用于保存:
- PENDING;
- STARTED;
- SUCCESS;
- FAILURE;
- RETRY;
- 任务返回值;
- 异常信息。
但在生产系统中,不能只依赖 Celery 状态。
因为 Celery 更关注执行状态,业务系统通常还需要自己的状态,例如:
UPLOADED
QUEUED
DOWNLOADING
PARSING
OCR_PROCESSING
INDEXING
SUCCESS
FAILED所以更推荐:
Celery 状态:任务执行层状态
业务数据库:真实业务状态5. Celery Beat
Celery Beat 是定时任务调度器。
例如:
- 每天凌晨清理临时文件;
- 每小时同步数据;
- 每五分钟检查一次任务;
- 每天生成业务日报。
Beat 本身通常不执行任务,只负责定时把任务发送到 Broker。
四、Celery + Redis 的完整工作流程
下面通过一个“文档解析任务”说明整个过程。
用户上传文件后,系统提交任务:
parse_document.delay(file_id=1001)背后大致会经历以下步骤。
第一步:Web 服务创建业务任务
系统先在数据库中创建一条任务记录:
task_id:80001
file_id:1001
status:CREATED为什么不能只使用 Celery 的 task ID?
因为业务系统通常还需要保存:
- 文件 ID;
- 用户 ID;
- 租户 ID;
- 执行进度;
- 当前阶段;
- 错误代码;
- 结果地址。
因此,一般会同时存在两个 ID:
业务任务 ID:用于业务查询
Celery task_id:用于 Celery 执行追踪第二步:发送任务
Web 服务调用:
result = parse_document.delay(
business_task_id=80001,
file_id=1001,
)Celery 会生成一个唯一的 task ID,并把任务转换成消息。
消息大致包含:
{<!-- -->
"task": "tasks.parse_document",
"id": "celery-task-uuid",
"args": [],
"kwargs": {<!-- -->
"business_task_id": 80001,
"file_id": 1001
}
}第三步:任务写入 Redis
Celery 将消息序列化后写入 Redis Broker。
这时任务只是进入了队列:
消息进入 Redis
≠
任务已经开始
≠
任务已经成功Web 服务可以立即返回:
{<!-- -->
"taskId": 80001,
"status": "QUEUED"
}第四步:Worker 获取任务
Celery Worker 一直监听 Redis。
当队列中出现新任务时,Worker 会取出消息,并根据任务名称找到对应的 Python 函数:
tasks.parse_document
↓
找到本地注册的 parse_documentWorker 本地必须已经安装并加载对应代码。
任务消息中不会包含 Python 函数本身,只包含任务名称和参数。
第五步:Worker 执行业务逻辑
任务开始执行:
@app.task
def parse_document(business_task_id, file_id):
update_status(business_task_id, "RUNNING")

file_path = download_file(file_id)
result = parse_pdf(file_path)
save_result(business_task_id, result)

update_status(business_task_id, "SUCCESS")

return {<!-- -->
"business_task_id": business_task_id,
"page_count": result.page_count,
}实际文档任务中可能包含:
下载文件
↓
解析 PDF
↓
执行 OCR
↓
提取表格和图片
↓
切分文本
↓
生成向量
↓
写入向量数据库第六步:保存任务结果
任务成功后,Celery 可以将结果写入 Result Backend:
{<!-- -->
"status": "SUCCESS",
"result": {<!-- -->
"business_task_id": 80001,
"page_count": 326
}
}同时,业务数据库也应该更新:
status:SUCCESS
progress:100
finished_at:完成时间
result_path:结果地址重要结果不要直接全部放入 Redis。
例如,不要让 Celery 返回数百 MB 的文档内容:
return huge_document_result更合理的是把真实结果存到数据库或对象存储,只返回引用:
return {<!-- -->
"result_path": "parse-results/80001/result.json"
}五、消息确认、重复执行与幂等
Celery 任务系统中,一个非常重要的问题是:
Worker 执行到一半崩溃怎么办?
这涉及消息确认,也就是 ACK。
1. 提前确认
提前确认的流程:
Worker 收到任务
↓
确认任务
↓
执行任务如果任务执行过程中 Worker 崩溃,Broker 可能认为任务已经完成,不再投递。
优点是任务不容易重复执行,缺点是任务可能丢失。
2. 执行后确认
可以配置:
task_acks_late = True流程变成:
Worker 收到任务
↓
执行任务
↓
执行成功
↓
确认任务如果 Worker 中途崩溃,任务可能重新进入队列,由其他 Worker 再执行一次。
这样可以减少任务丢失,但会带来另一个问题:
同一个任务可能执行多次。
因此,开启晚确认后,任务必须具备幂等性。
3. 什么是幂等
幂等是指:
同一个任务执行一次或多次,最终业务结果相同。
例如下面的操作通常是幂等的:
将任务状态设置为 SUCCESS执行十次,最终还是 SUCCESS。
但下面的操作不是幂等的:
给用户发送一封邮件
账户扣款 100 元
插入一条新数据重复执行可能产生多封邮件、多次扣款或重复记录。
4. 常见幂等方式
唯一约束
例如一个文件只能生成一份指定版本的解析结果:
UNIQUE(file_id, parse_version)重复执行时,数据库阻止重复数据。
条件更新
UPDATE task
SET status = 'RUNNING'
WHERE id = 80001
AND status = 'QUEUED';只有第一个 Worker 能成功把状态从 QUEUED 改成 RUNNING。
幂等业务键
document_parse:1001:v1每次任务执行前先判断该业务键是否已经成功处理。
先计算,后原子提交
推荐流程:
读取数据
↓
执行计算
↓
生成临时结果
↓
一次性提交最终结果减少任务执行一半时留下脏数据的风险。
六、失败重试与超时
分布式系统中,失败是正常现象。
常见临时错误包括:
- 网络抖动;
- 对象存储短暂不可用;
- 数据库连接失败;
- 第三方接口超时;
- 大模型接口限流;
- Redis 短暂断开。
这些错误通常可以重试。
@app.task(
bind=True,
autoretry_for=(ConnectionError,),
retry_backoff=True,
retry_jitter=True,
max_retries=5,
)
def process_task(self, task_id):
return execute_task(task_id)这里:
autoretry_for:指定哪些异常自动重试
retry_backoff:使用指数退避
retry_jitter:加入随机抖动
max_retries:最大重试次数指数退避类似:
第一次失败:1 秒后重试
第二次失败:2 秒后重试
第三次失败:4 秒后重试
第四次失败:8 秒后重试这样可以避免下游系统已经过载时,所有任务立即重复请求。
并不是所有错误都应该重试。
例如:
- 文件已经损坏;
- 参数错误;
- 用户无权限;
- 文件格式不支持;
- 业务数据不存在。
这些属于永久错误,重试通常没有意义。
七、并发模型与队列划分
Celery 可以同时执行多个任务。
常见 Worker 启动方式:
celery -A app worker --concurrency=4表示 Worker 同时拥有 4 个执行槽位。
但并发数不是越大越好,需要根据任务类型决定。
| 任务类型 | 特点 | 建议 |
|---|---|---|
| PDF 解析 | CPU、内存密集 | 低到中等并发 |
| OCR | CPU 或 GPU 密集 | 独立 Worker |
| 接口调用 | 网络 I/O 密集 | 可以适当提高并发 |
| 邮件发送 | 网络 I/O 密集 | 中等并发 |
| Playwright 爬虫 | 内存和浏览器资源密集 | 严格限制并发 |
| 大模型推理 | GPU 显存密集 | 独立部署和限流 |
不同任务最好拆到不同队列:
document_parse
ocr
crawler
notification
llm例如:
app.conf.task_routes = {<!-- -->
"tasks.parse_document": {<!-- -->
"queue": "document_parse"
},
"tasks.run_ocr": {<!-- -->
"queue": "ocr"
},
"tasks.send_email": {<!-- -->
"queue": "notification"
},
}再启动不同 Worker:
celery -A app worker -Q document_parse --concurrency=4celery -A app worker -Q crawler --concurrency=2这样可以避免一个耗时很长的爬虫任务,占用文档解析或邮件任务的执行资源。
八、生产环境中的推荐设计
一套比较合理的架构如下:
核心设计原则有以下几条。
1. Web 服务只负责提交任务
不要在 API 中这样做:
result = task.delay()
return result.get(timeout=600)虽然使用了 Celery,但接口仍然在同步等待,失去了异步任务的意义。
正确方式是立即返回任务 ID。
2. 大文件不进入 Redis
错误方式:
parse_document.delay(file_bytes)正确方式:
parse_document.delay(file_id)文件存入 MinIO 或 S3,消息中只传文件 ID 或对象存储 Key。
3. 业务状态存数据库
Celery 状态只适合描述任务执行情况。
真正的业务状态应保存在数据库,例如:
QUEUED
DOWNLOADING
PARSING
OCR
INDEXING
SUCCESS
FAILED4. 不同任务使用不同队列
不要把所有任务都放进默认队列。
应该根据:
- 任务耗时;
- 资源类型;
- 优先级;
- 业务重要性;
进行队列划分。
5. 任务必须设置超时
网络请求、文件下载和第三方接口调用,都应该设置明确超时。
Celery 任务本身也可以设置:
soft_time_limit=1800
time_limit=1860防止任务永久卡死。
6. Worker 要定期回收
某些文档解析、图片处理或浏览器任务可能存在内存无法完全释放的问题。
可以配置 Worker 子进程执行一定任务数后重启:
worker_max_tasks_per_child = 100避免单个进程长期运行后内存不断上涨。
7. 做好监控与日志
至少需要关注:
- 队列长度;
- 任务等待时间;
- 任务执行时间;
- 任务成功率;
- 任务失败率;
- 重试次数;
- Worker 在线数量;
- Redis 内存;
- 数据库连接数。
日志中建议包含:
business_task_id
celery_task_id
user_id
file_id
worker_name
retry_count
current_stage这样才能从一次用户请求追踪到后台任务的完整链路。
九、一个简化的配置示例
from celery import Celery

app = Celery(
"document_service",
broker="redis://redis:6379/0",
backend="redis://redis:6379/1",
)

app.conf.update(
task_serializer="json",
result_serializer="json",
accept_content=["json"],

task_track_started=True,
task_acks_late=True,

worker_prefetch_multiplier=1,
worker_max_tasks_per_child=100,

result_expires=86400,

broker_connection_retry_on_startup=True,

task_routes={<!-- -->
"tasks.parse_document": {<!-- -->
"queue": "document_parse",
},
"tasks.run_ocr": {<!-- -->
"queue": "ocr",
},
"tasks.send_notification": {<!-- -->
"queue": "notification",
},
},
)这段配置表达了几个重要思路:
- 使用 JSON 序列化;
- 记录任务开始状态;
- 执行完成后再确认;
- 长任务减少预取;
- 定期回收 Worker 子进程;
- 任务结果一天后过期;
- 不同任务进入不同队列。
具体参数仍然需要根据业务任务耗时和资源情况调整。
十、总结
Celery + Redis 的完整工作流程可以概括为:
1. 用户提交任务
2. Web 服务创建业务任务记录
3. Celery 生成任务消息
4. 消息写入 Redis Broker
5. Web 服务立即返回任务 ID
6. Worker 从 Redis 获取任务
7. Worker 执行业务逻辑
8. 结果写入数据库或对象存储
9. Celery 保存任务执行状态
10. Worker 确认任务完成
11. 用户通过任务 ID 查询结果各组件的职责分别是:
Celery:
负责定义、发送、调度和执行任务

Redis Broker:
负责保存和传递任务消息

Celery Worker:
负责执行真正的业务代码

Result Backend:
负责保存 Celery 状态和轻量结果

业务数据库:
负责保存真实业务状态

对象存储:
负责保存文件和大型结果真正的生产级异步任务系统,并不是简单地安装 Celery 和 Redis。
还需要重点处理:
任务拆分
队列隔离
失败重试
超时控制
消息确认
幂等设计
业务状态
资源限制
监控告警可以把 Celery 理解为任务执行框架,把 Redis 理解为任务中转站。
而系统是否可靠,最终取决于业务层能否正确处理任务重复、任务失败、Worker 宕机和数据不一致等问题。