
CSDN 原文镜像
本文为作者 CSDN 博客的全文镜像,原文发布于 2026-08-10。本站补充导读与相关主线链接,并修复代码展示;原文观点、来源与发布时间保留。
- 原文链接:https://blog.csdn.net/m0_63309778/article/details/163633108
- 站内分区:Agent / Agent Stream URL
站内导读与实践边界
本文解释创建任务与观察任务的解耦。streamUrl 是应用层设计,不是 SSE 必须提供的字段;短任务也可用单请求流式响应。独立订阅接口仍要验证用户对 run 的权限、事件保留范围与游标,断开订阅和取消任务应有不同语义。
前言
在接入大模型、Agent 或异步任务系统时,我们经常会看到接口返回类似这样的结构:
{
"runId": "run_001",
"messageId": "msg_001",
"status": "running",
"streamUrl": "/api/runs/run_001/events"
}很多第一次看到 streamUrl 的人会有一个疑问:
既然已经调用了接口,为什么不直接在当前请求里持续返回流式内容,还要额外返回一个 URL?
实际上,这背后反映的是两种完全不同的系统设计思路。
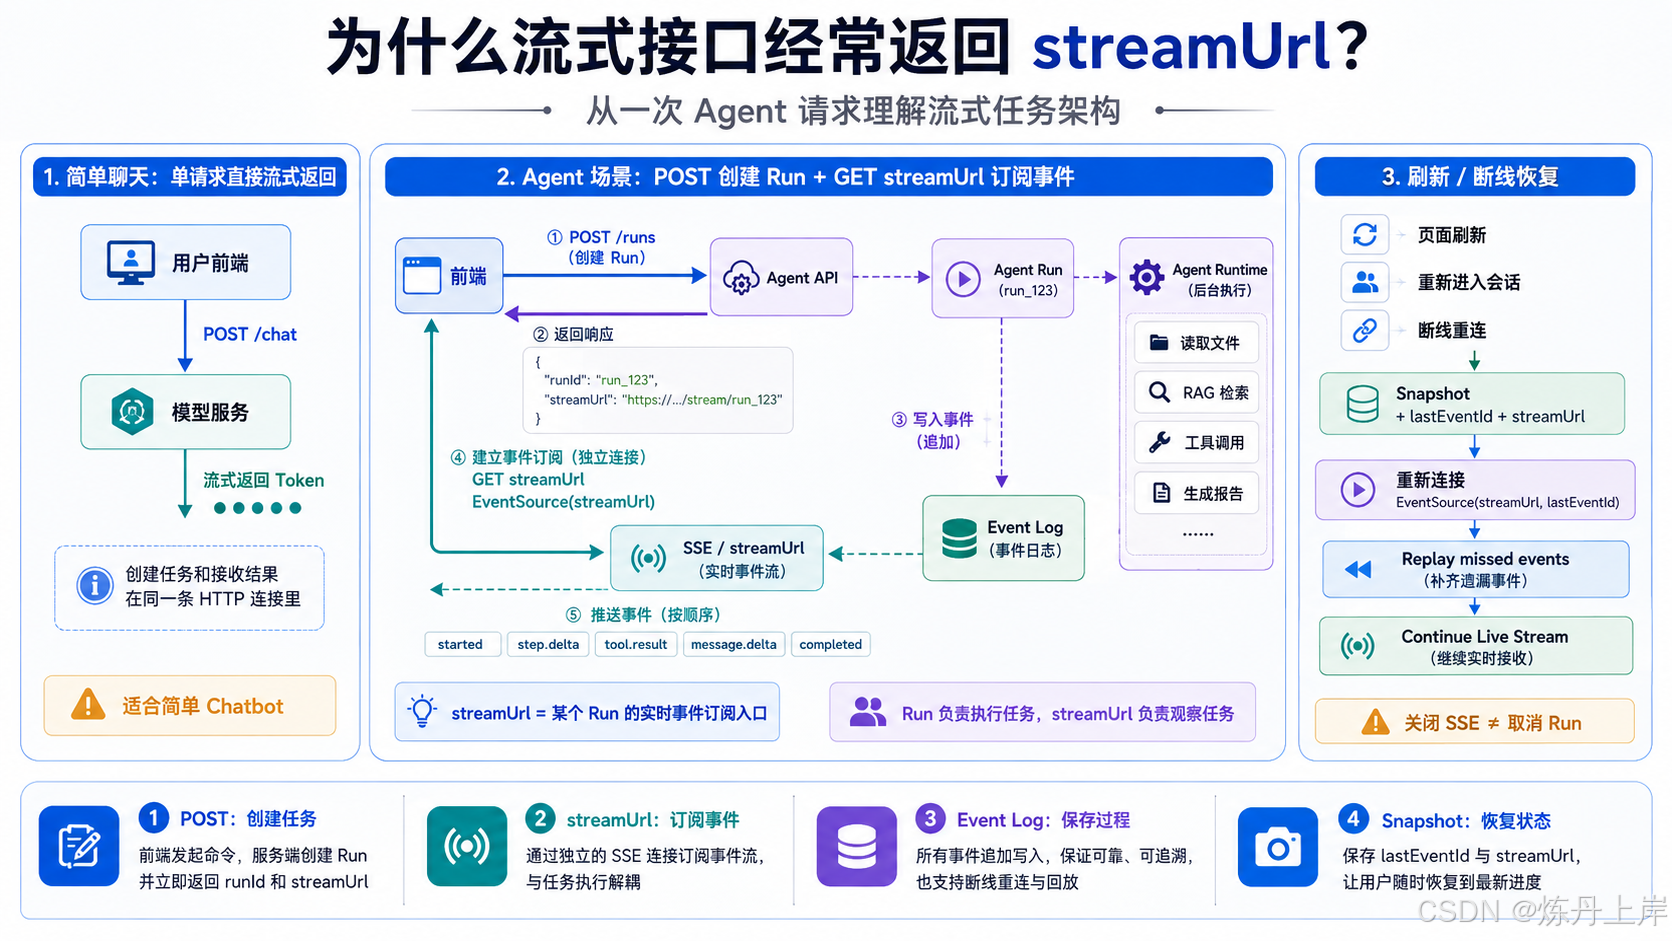
简单聊天系统往往把“创建任务”和“接收流式结果”放在同一个 HTTP 请求里;而复杂 Agent 系统更倾向于把这两件事情拆开:
创建任务
+
订阅任务事件streamUrl 的本质,就是后者。
它不是一个“下载最终答案的地址”,而是:
某个持续运行任务对应的实时事件订阅入口。
理解这一点之后,Agent 中的 SSE、Run、断线恢复、页面刷新、事件回放等设计就能串起来了。
一、最简单的流式接口是怎么做的
先从普通大模型聊天开始。
用户发送请求:
POST /api/chat服务端收到请求后调用模型,并直接通过当前 HTTP Response 持续向客户端写入内容:
data: {"delta":"你好"}

data: {"delta":",我是"}

data: {"delta":"智能助手"}

data: [DONE]整个生命周期可以理解为:
发送请求
↓
模型开始生成
↓
当前 HTTP 连接持续返回 Token
↓
模型完成
↓
连接关闭这种设计非常简单。
前端只需要发一次请求,然后一直读取响应流即可。
对于普通 Chatbot,这通常完全够用,因为一次请求的生命周期非常清晰:
用户提问
↓
模型生成
↓
生成完成问题在于,Agent 往往不是这样。
二、Agent 的生命周期通常比 HTTP 请求复杂得多
假设用户提交一个任务:
帮我分析这份 300 页的招标文件,并生成风险报告。
后台可能经历:
创建 Agent Run
↓
读取文件
↓
PDF 解析
↓
OCR
↓
知识库检索
↓
模型分析
↓
调用工具
↓
生成报告
↓
保存 Artifact
↓
Run 完成整个过程可能持续几十秒,甚至几分钟。
期间用户可能:
- 切换到另一个会话;
- 刷新页面;
- 关闭浏览器;
- 网络断开;
- 稍后重新进入;
- 在另一个标签页查看任务;
- 等 Agent 跑完后再回来。
如果 Agent 的运行生命周期完全绑定在最开始那条 HTTP 请求上:
POST /agent/run
│
│ 长时间保持连接
│
↓
Agent Runtime就会遇到一个很明显的问题:
页面刷新
↓
HTTP 连接断开
↓
Agent 怎么办?理想情况下,Agent 应该继续在后台运行。
但此时原来的 HTTP Response 已经不存在了。
这说明:
Agent Run 和浏览器当前这条网络连接,本来就不应该是同一个东西。
于是系统开始把两者拆开。
三、streamUrl 的核心:把“执行任务”和“观察任务”分离
更成熟的设计通常是:
第一步:创建任务
第二步:订阅任务事件例如:
POST /api/runs服务端创建 Agent Run 后立即返回:
{
"runId": "run_001",
"status": "running",
"streamUrl": "/api/runs/run_001/events"
}这时 POST /api/runs 已经结束了。
Agent 则继续在后台运行。
前端随后拿 streamUrl 建立 SSE:
const source = new EventSource(
"/api/runs/run_001/events"
);于是整个架构变成:
                创建任务
↓
前端 ── POST ──→ Agent Run
│
│ 后台继续执行
↓
Event Stream
↑
│
前端 ── GET ─── streamUrl此时:
Run代表真正的后台执行。
而:
streamUrl只代表:
当前客户端通过什么地址观察这个 Run 的实时变化。
这是 Agent 架构中非常重要的一次解耦。
四、streamUrl 到底是什么
streamUrl 并不是 SSE 协议规定的标准字段。
它只是业务系统常用的一个命名。
也可能叫:
eventsUrl
subscribeUrl
streamEndpoint
eventStreamUrl本质都一样:
指向一个可以建立持续事件连接的 HTTP 地址。
例如:
/api/runs/run_001/events这个接口通常返回:
Content-Type: text/event-stream然后持续发送事件:
event: run.started
id: 1001
data: {"runId":"run_001"}

event: message.item.created
id: 1002
data: {"itemId":"text_001"}

event: message.item.delta
id: 1003
data: {"delta":"我会先分析"}

event: tool.started
id: 1004
data: {"tool":"parse_document"}

event: tool.completed
id: 1005
data: {"tool":"parse_document"}

event: message.item.delta
id: 1006
data: {"delta":"这份文件存在三项风险"}

event: run.completed
id: 1007
data: {"runId":"run_001"}因此,更准确地说:
streamUrl
=
Run Event Stream Subscription URL也就是:
某一次 Run 的事件订阅地址。
五、为什么 Agent 更适合“POST 创建 + GET SSE”
这其实是一个控制面和事件面的分离。
可以把整个 Agent 系统理解成:
Command
+
Event用户通过普通 HTTP 接口发出命令:
发送消息
取消任务
重试任务
确认审批例如:
POST /runs
POST /runs/{id}/cancel
POST /approvals/{id}/approve而 Agent 的运行变化则通过流式接口持续推送:
run.started
plan.updated
message.delta
tool.started
tool.completed
artifact.created
approval.required
run.completed于是整个架构非常清晰:
REST API
负责告诉 Agent:
“你要做什么”

SSE
负责告诉前端:
“Agent 现在发生了什么”这比把所有事情强行放在一条长连接中更加适合复杂 Agent 系统。
六、为什么关闭 streamUrl 不应该停止 Agent
一旦 Run 和 Stream 被拆开,一个重要原则就出现了:
关闭 SSE
≠
取消 Run假设用户正在查看:
Conversation AAgent 正在执行。
用户切换到:
Conversation B前端可以关闭 Conversation A 对应的 EventSource:
eventSource.close();这只是表示:
当前页面不再订阅 Conversation A 的实时事件。
但后台 Agent 仍然继续执行:
Agent Runtime
↓
调用模型
↓
执行工具
↓
保存事件
↓
更新状态如果用户真的想停止任务,应该调用单独的取消接口:
POST /api/runs/run_001/cancel所以应该明确区分两个动作:
unsubscribe
停止看

cancel
停止做这是设计 Agent UI 时非常重要的概念。
七、streamUrl 为什么天然适合页面刷新和重新进入
这也是它最有价值的地方之一。
假设 Agent 当前运行到:
Event 1005前端已经收到:
1001
1002
1003随后用户刷新页面。
刷新后:
EventSource 对象消失
前端内存消失
原来的 HTTP 连接消失但后台 Agent 并不会因此停止。
它继续产生:
1004
1005
1006用户重新进入页面时,可以先获取会话状态:
GET /api/conversations/conv_001返回:
{
"activeRun": {
"id": "run_001",
"status": "running",
"streamUrl": "/api/runs/run_001/events",
"lastEventId": "1003"
}
}这时前端重新连接:
streamUrl
+
lastEventId就可以继续恢复。
因此可以这样理解:
streamUrl
回答:
“去哪里接收事件?”

lastEventId
回答:
“从哪里继续?”这两个参数通常天然配套。
八、streamUrl 和 Event Replay 是如何配合的
一个生产级 Agent 系统通常不会只做实时 SSE,而会保存事件日志。
例如:
1001 run.started
1002 message.item.created
1003 message.item.delta
1004 tool.started
1005 tool.completed
1006 message.item.delta
1007 run.completed假设客户端最后确认收到:
1003然后断线。
重新连接时:
GET /api/runs/run_001/events?after=1003服务端先补发:
1004
1005
1006
1007然后如果 Run 还没有结束,再进入实时等待。
整个流程就变成:
连接 streamUrl
↓
读取 after / lastEventId
↓
补发历史事件
↓
追平当前状态
↓
继续监听实时事件因此,一个完整的 stream 接口往往同时承担两种职责:
Replay
+
Live Stream既能补历史,又能接实时。
九、为什么还需要 Snapshot,不能只靠 streamUrl
有了事件日志之后,一个新的问题出现了。
假设一个会话已经运行很久,产生了 10 万条 message.delta。
用户重新进入页面时,如果从第一条事件开始重放:
1
2
3
……
100000显然很低效。
所以系统通常还会保存 Snapshot。
例如数据库中保存:
agent_message.content
run.status
tool_call.status
artifact
plan用户进入页面时:
先读取 Snapshot
↓
快速恢复当前完整界面然后通过:
streamUrl + lastEventId补上 Snapshot 之后的新事件。
因此,Agent 状态恢复通常采用:
Snapshot
+
Event Log
+
Live Stream三者职责分别是:
Snapshot
告诉你:
“现在是什么样”

Event Log
告诉你:
“中间发生了什么”

Live Stream
告诉你:
“现在正在发生什么”而 streamUrl 主要负责后两部分。
十、为什么后端直接返回 streamUrl,而不是前端自己拼
很多系统的 stream 地址其实非常规律:
/api/runs/{runId}/events那么前端完全可以:
const streamUrl =
`/api/runs/${runId}/events`;这是可以的。
但在更复杂的系统里,让后端返回 streamUrl 会更灵活。
首先,它可以减少前后端对 URL 结构的耦合。
如果以后接口从:
/api/runs/{id}/events变成:
/api/v2/streams/{streamId}前端无需修改 URL 拼接逻辑,只需要继续使用:
new EventSource(result.streamUrl);其次,Stream 本身可能逐渐成为独立资源。
例如:
runId = run_001

streamId = stream_8899此时:
Run和:
Stream甚至不一定严格一对一。
此外,后端还可以直接返回带鉴权能力的临时地址:
https://stream.example.com/events/abc
?token=xxx
&expires=...这样前端无需理解:
- Stream 服务部署在哪里;
- Token 如何签名;
- 当前应该连接哪个区域;
- 网关如何路由;
- Stream ID 如何生成。
十一、streamUrl 还能帮助独立部署 SSE Gateway
随着 Agent 平台规模增加,普通 API 和 SSE 长连接的运行特征会越来越不一样。
普通 API 通常是:
请求
↓
快速处理
↓
返回
↓
连接结束而 SSE 是:
建立连接
↓
持续保持几分钟
↓
不断发送事件
↓
Run 结束后关闭两者对于基础设施的要求不同。
SSE 更关注:
- 长连接数量;
- Connection Timeout;
- Nginx Buffering;
- Keepalive;
- 网关最大连接数;
- 心跳;
- 断线检测;
- 水平扩容。
因此大型架构可能逐渐拆成:
              ┌── Agent API Service
客户端 ───────┤
└── SSE Gateway创建任务:
POST https://api.example.com/runs返回:
{
"runId": "run_001",
"streamUrl": "https://stream.example.com/runs/run_001/events"
}然后浏览器直接连接专门的 Stream 服务。
此时 streamUrl 就不仅仅是一个接口路径,而是:
后端告诉客户端此次任务应该去哪里订阅事件。
十二、streamUrl 和 WebSocket 有什么不同
WebSocket 的典型模型是:
Browser
⇅
WebSocket
⇅
Server客户端和服务器都可以在同一条连接上主动发送消息。
因此可以把:
发送消息
工具状态
Token 输出
审批操作全部塞进同一条 WebSocket。
而 SSE 通常采用:
普通 HTTP
负责上行控制

SSE
负责下行事件例如:
POST /runs
POST /runs/{id}/cancel
POST /approvals/{id}/approve

GET /runs/{id}/events这非常符合大多数 Agent 产品的交互特点。
用户主动操作并没有那么高频,通常只是:
发送问题
点击取消
确认审批
重新执行而服务端事件却很多:
message.delta
tool.started
tool.completed
plan.updated
artifact.created
run.progress
run.completed也就是:
客户端 → 服务端
低频

服务端 → 客户端
高频这种情况下:
REST + SSE往往非常自然。
十三、一个推荐的 Agent Stream 接口设计
创建 Run:
POST /api/conversations/{conversationId}/messages返回:
{
"messageId": "msg_001",
"runId": "run_001",
"status": "running",
"streamUrl": "/api/runs/run_001/events"
}前端连接:
const source = new EventSource(streamUrl);Stream 接口:
GET /api/runs/run_001/events支持:
after
Last-Event-ID事件格式:
event: message.item.delta
id: 1058
data: {...}建议至少包含:
eventId
sequence
type
runId
conversationId
timestamp
payloadRun 结束时明确发送:
run.completed
run.failed
run.cancelled前端收到终态事件后关闭连接。
如果页面刷新,则:
读取 Conversation Snapshot
↓
识别 activeRun
↓
拿到 streamUrl
↓
拿到 lastEventId
↓
重新订阅这样整个 Agent 对话的恢复链路就完整了。
十四、常见误区
第一个误区是把 streamUrl 当成最终结果下载地址。
实际上它通常是事件订阅地址,不代表最终结果本身。
第二个误区是 SSE 断开就停止 Agent。
SSE 是观察通道,Run 才是执行主体。
第三个误区是每次重新进入页面都重新创建 Run。
正确方式应该是发现旧 Run 仍然在执行,然后重新连接旧 Run 的 streamUrl。
第四个误区是只有 streamUrl,没有事件持久化。
这种情况下虽然可以实时推送,但用户离开期间产生的事件仍然无法补发。
第五个误区是只保存 Event Log,不保存 Snapshot。
这样长会话每次恢复都需要重放大量事件,成本很高。
结语
streamUrl 看起来只是接口返回中的一个 URL,但它背后其实代表了一种非常重要的系统设计:
将任务执行生命周期与当前浏览器连接生命周期解耦。
在简单聊天中,可以直接使用:
POST
+
Streaming Response但在复杂 Agent 系统中,更适合:
POST 创建 Run
+
GET streamUrl 订阅事件于是:
Run
负责真正执行任务

streamUrl
负责观察 Run

Event Log
负责保存运行过程

Snapshot
负责恢复完整状态

lastEventId
负责断线续接最终形成:
用户提交任务
↓
创建 Agent Run
↓
立即返回 runId + streamUrl
↓
Agent 在后台持续执行
↓
事件写入 Event Log
↓
前端通过 streamUrl 实时订阅
↓
页面刷新 / 网络断开
↓
读取 Snapshot + lastEventId
↓
重新连接 streamUrl
↓
补发遗漏事件
↓
继续实时接收因此,可以用一句话理解 streamUrl:
streamUrl 不是“答案在哪里”,而是“这个持续运行的任务,现在应该去哪里监听它发生了什么”。
当 Agent 逐渐从简单问答走向工具调用、长任务、后台执行、Human-in-the-loop 和多 Agent 协作时,这种“Command API + Event Stream”的设计会越来越重要。